
핵심 키워드: Enterprise AI 보안, AI 권한 관리, Permission Scope, 데이터 접근 권한, SQL 보안, 데이터 거버넌스, SELMA
앞선 글에서는 SELMA에서 매출, 주문, 고객 같은 Business Meaning을 LLM이 아닌 Contract가 결정하도록 만든 이유를 이야기했습니다.
하지만 기업 데이터를 AI와 연결하면서 의미의 정확성만큼 중요했던 문제가 하나 더 있었습니다.
바로 권한(Permission)입니다.
사용자가 자연어로 자유롭게 질문할 수 있다는 것은 반대로 생각하면 예상하지 못했던 방식으로 데이터에 접근할 수도 있다는 의미입니다.
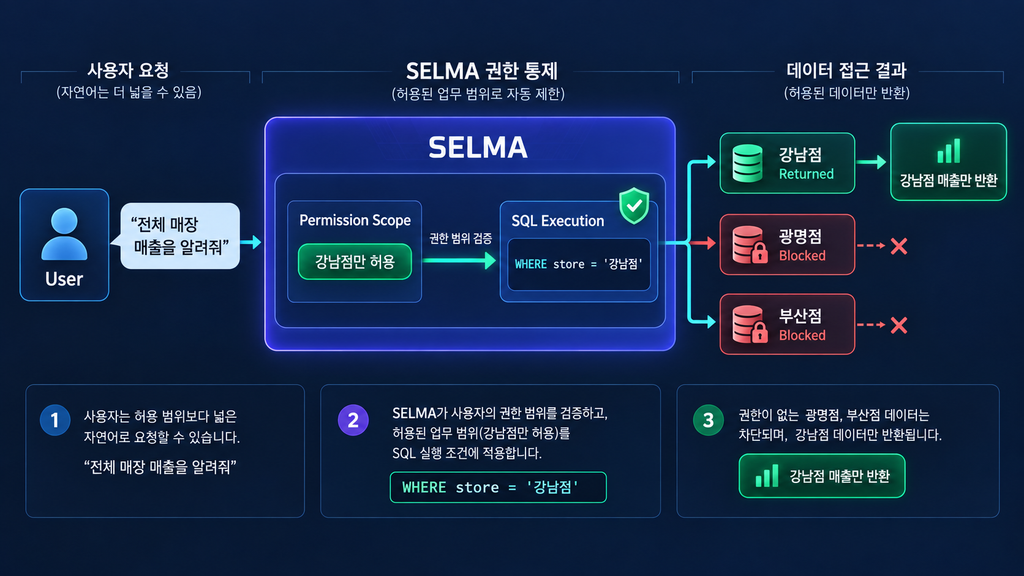
예를 들어 강남점 데이터만 볼 수 있는 사용자가 이렇게 질문했다고 가정해보겠습니다.
“전국 매장의 이번 달 매출을 알려줘.”
AI가 질문을 완벽하게 이해하고 정확한 SQL을 생성했다고 해도 전체 매출을 보여줘서는 안 됩니다.
SELMA를 개발하면서 내린 결론은 명확했습니다.
Permission은 AI의 답변을 제한하는 것이 아니라 실제 데이터 읽기를 제한해야 한다.
화면에서 데이터를 숨기는 것만으로는 부족하다
일반적인 업무 시스템에서는 메뉴나 화면을 권한에 따라 숨기는 방식을 자주 사용합니다.
하지만 AI에서는 사용자가 메뉴를 클릭하는 대신 자연어로 질문합니다.
따라서 UI에서 특정 메뉴를 감췄다고 데이터 접근까지 막았다고 볼 수 없습니다.
API 단계에서 사용자의 권한을 확인하는 것도 중요하지만 이것만으로 충분하지 않았습니다.
중간의 Semantic Runtime이나 분석 Tool에서 Scope가 사라진다면 최종 SQL은 사용자가 볼 수 없는 데이터까지 조회할 수 있기 때문입니다.
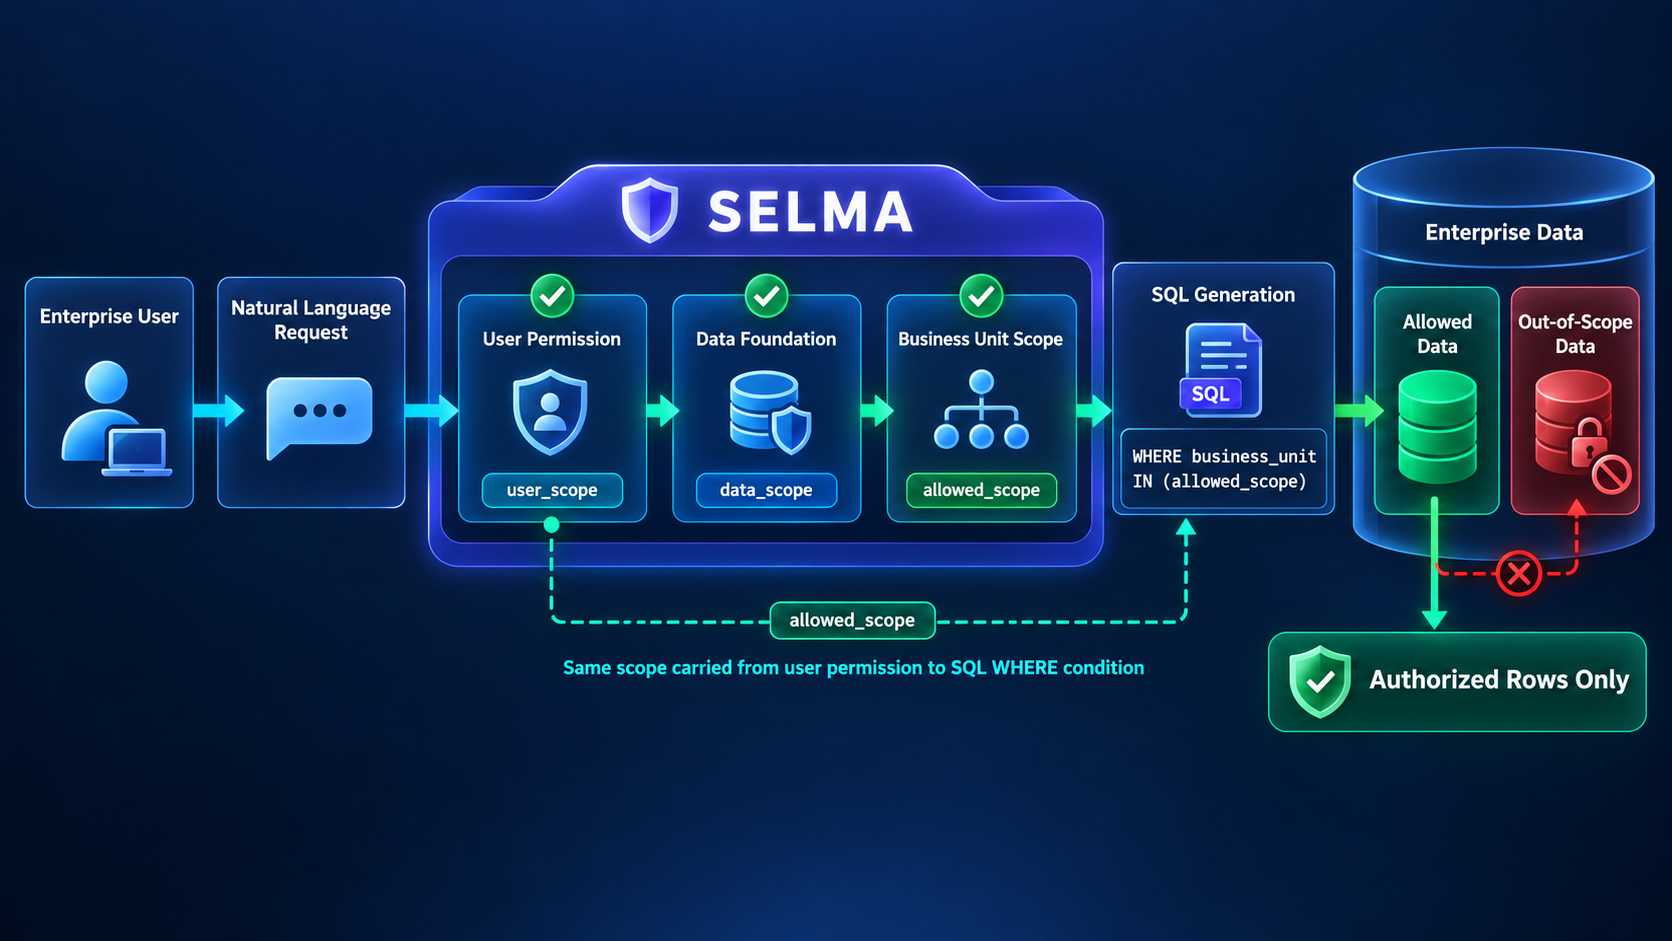
그래서 SELMA에서는 다음과 같은 흐름을 지향했습니다.
사용자 → Permission 확인 → 읽을 수 있는 Data Foundation → 허용된 Business Scope → SQL 생성 → Scope가 적용된 SQL 실행
권한 정보가 중간에서 사라지지 않고 데이터베이스가 실제로 읽는 범위까지 내려가야 합니다.
코드에 Permission Check가 있다고 믿을 수 있을까?
SELMA의 권한 구조를 점검하면서 처음에는 Repository에서 Permission Check가 존재하는지 조사했습니다.
코드를 보면 상당히 잘 보호되어 있는 것처럼 보였습니다.
그런데 여기서 검증 방법을 바꿨습니다.
코드를 읽는 대신 실제로 권한 경계를 넘어보기로 했습니다.
서로 다른 조직을 만들고 다른 조직의 사용자, 설계 자산, 데이터 연결 등에 접근을 시도했습니다.
첫 측정에서는 21개의 권한 경계 중 3개가 실제로 넘어갔습니다.
코드에 권한 검사가 존재한다는 사실과 실제 시스템의 모든 경로에서 권한이 유지된다는 것은 다른 문제였습니다.
이 경험 이후 보안 테스트를 보는 관점도 달라졌습니다.
“Permission 코드가 있는가?”
보다
“권한이 없는 사용자가 실제로 이 경계를 넘을 수 있는가?”
를 직접 확인하는 것이 더 중요했습니다.
가장 어려웠던 것은 고객마다 데이터 구조가 다르다는 점
Enterprise AI의 Permission Scope를 구현하면서 또 다른 문제가 나타났습니다.
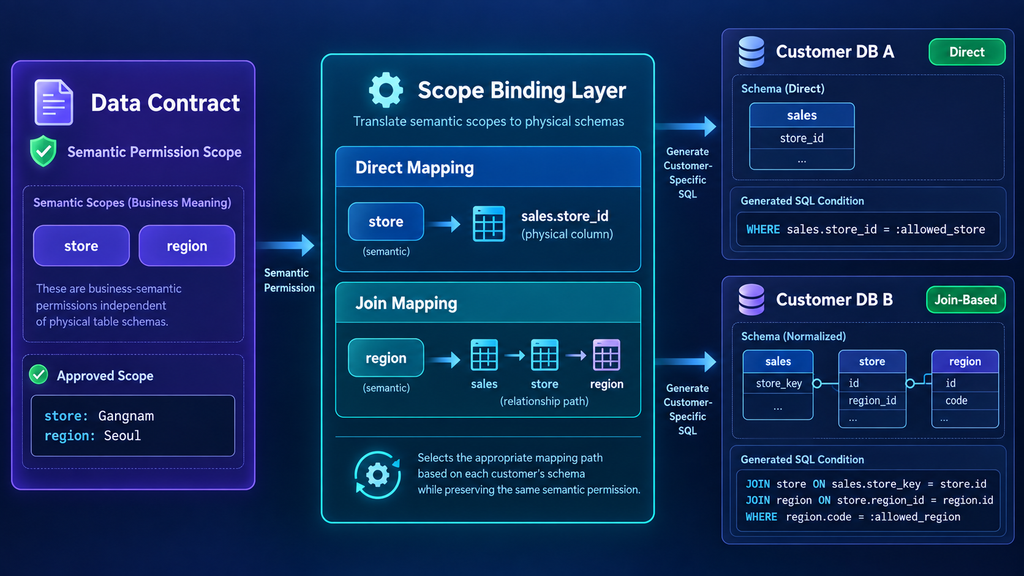
기업마다 사업장이나 조직 범위를 표현하는 데이터 구조가 달랐습니다.
어떤 데이터베이스에서는 store_code가 기본 테이블에 있었습니다.
다른 고객 데이터에서는 region을 얻기 위해 여러 테이블을 JOIN해야 했습니다.
초기 구현에서는 이런 범위를 물리적인 SQL 컬럼이나 Alias로 표현하는 부분이 있었습니다.
예를 들어 특정 고객에서는 j3.region 같은 물리적인 SQL 표현이 권한 의미를 대신하고 있었습니다.
해당 SQL 구조에서는 동작했습니다.
하지만 다른 형태의 Query에서는 j3라는 Alias 자체가 존재하지 않을 수 있습니다.
실제로 이런 문제로 특정 분석 Tool들이 데이터베이스 실행 단계에서 실패하는 결함도 발견했습니다.
권한도 물리 컬럼이 아니라 Semantic Contract로
문제를 해결하면서 중요한 방향을 하나 정했습니다.
권한의 의미를 SQL의 물리적인 철자와 분리하는 것입니다.
Contract는 j3.region 같은 특정 Query의 Alias를 권한의 정체성으로 기억하지 않습니다.
대신 region, store처럼 권한이 걸리는 Semantic Dimension을 선언합니다.
실제 SQL을 만드는 Runtime이 자신의 Query 구조에 맞춰 그 의미를 물리적인 데이터 관계로 변환합니다.
이렇게 하면 Business Meaning과 Permission 모두 같은 원칙을 따르게 됩니다.
의미는 Contract가 선언하고, 물리적인 실행은 Runtime이 책임진다.
권한 때문에 숫자가 달라져서도 안 된다
권한을 적용하면서 예상하지 못했던 또 하나의 문제는 집계 단위(Grain)였습니다.
권한 컬럼을 찾기 위해 새로운 JOIN을 추가했는데 그 관계가 one-to-many라면 원래 한 건이 여러 행으로 늘어날 수 있습니다.
그러면 권한 밖 데이터는 차단했지만 매출이나 주문 건수가 중복 계산될 수 있습니다.
보안은 맞는데 분석 결과가 틀리는 것입니다.
그래서 SELMA에는 이런 원칙도 생겼습니다.
Scope may remove facts, but it must never change their grain.
권한은 사용자가 볼 수 없는 사실을 제거할 수 있습니다.
하지만 권한을 적용했다는 이유로 하나의 사실을 두 개로 만들거나 집계 구조를 바꿔서는 안 됩니다.
이 원칙 때문에 단순히 SQL에 WHERE 하나를 추가하는 것보다 훨씬 많은 검증이 필요했습니다.
Enterprise AI의 권한은 실행 가능한 계약이어야 한다
SELMA를 개발하면서 AI 권한 관리를 단순한 로그인이나 Role 설정의 문제로만 보기 어려워졌습니다.
사용자가 자연어로 어떤 질문을 하더라도,
어떤 Data Foundation을 읽을 수 있는지, 어떤 조직 범위까지 접근할 수 있는지, 그 Scope가 실제 SQL까지 유지되는지가 하나의 흐름으로 연결되어야 했습니다.
그리고 중요한 경계는 코드 리뷰만으로 확인하지 않고 실제로 깨뜨려봐야 했습니다.
제가 SELMA에서 지향하는 Permission 구조를 한 문장으로 정리하면 이렇습니다.
AI가 무엇을 알고 있느냐보다,
무엇을 실제로 읽을 수 있도록 허용했는지가 더 중요하다.
Enterprise AI가 앞으로 데이터를 읽는 것을 넘어 실제 업무를 수정하는 Transaction Write까지 수행하게 된다면 이 원칙은 더욱 중요해질 것입니다.
읽기 권한이 잘못되면 정보가 노출될 수 있지만, 쓰기 권한이 잘못되면 실제 업무 상태가 바뀔 수 있기 때문입니다.
다음 8편에서는 SELMA Architecture Hardening의 출발점이 됐던 문제를 다뤄보겠습니다. 수많은 테스트가 모두 통과하고 있었는데도 Architecture가 잘못되어 있었던 이유, 그리고 왜 기능 테스트와 별도로 Architecture Invariant가 필요했는지 실제 사례를 중심으로 정리하겠습니다.
#EnterpriseAI #AI보안 #AI권한관리 #PermissionScope #데이터접근권한 #SQL보안 #데이터거버넌스 #AIGovernance #AI에이전트 #기업데이터 #소프트웨어아키텍처 #SELMA