

핵심 키워드: AI 시대 개발자, AI 코딩, 바이브 코딩, 개발자 역할, AI Engineering, 소프트웨어 아키텍처, Enterprise AI, SELMA
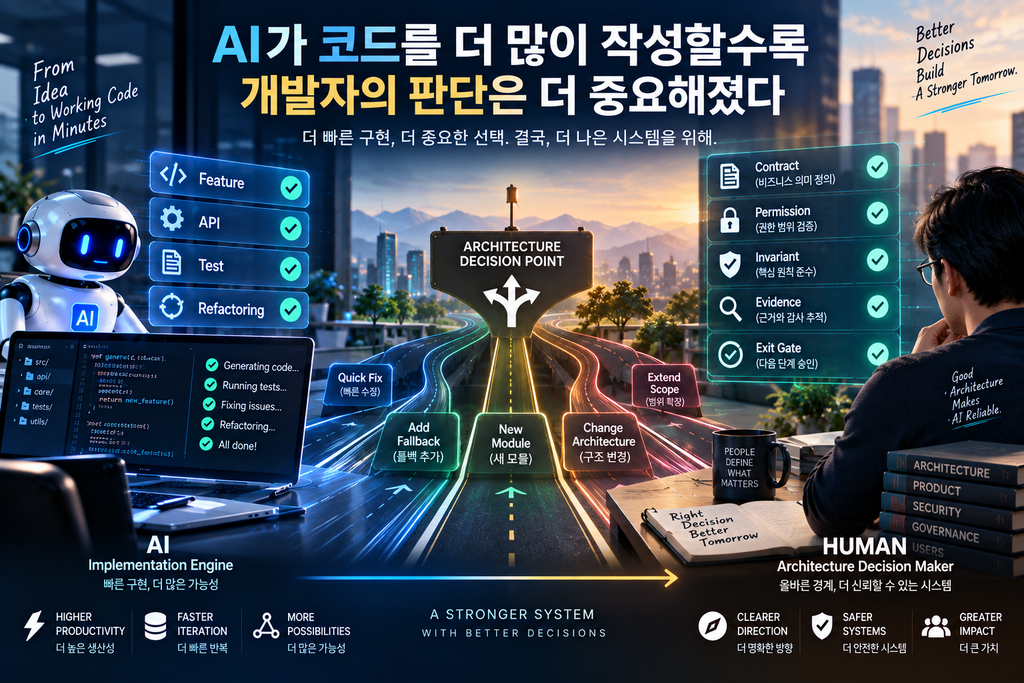
AI가 코드를 이렇게 잘 작성한다면 앞으로 개발자는 필요 없어지는 것 아닐까?
생성형 AI와 바이브 코딩 이야기가 나올 때 자주 등장하는 질문입니다.
개인 프로젝트 SELMA를 AI와 함께 개발하면서 저 역시 이 질문을 여러 번 생각했습니다.
실제로 제가 직접 코드를 타이핑하는 시간은 이전보다 크게 줄었습니다.
기능 구현, 테스트 작성, 오류 분석, Repository 검색, 리팩토링까지 AI가 상당한 부분을 담당했습니다.
그런데 프로젝트 규모가 커질수록 예상과 조금 다른 변화가 나타났습니다.
코드를 작성하는 일은 줄었지만 판단해야 할 일은 오히려 늘어났습니다.
AI는 대부분 어떻게든 코드를 만들어냈다
SELMA를 개발하면서 AI에게 기능 구현을 요청했을 때 가장 어려웠던 문제는 “AI가 코드를 만들 수 있는가?”가 아니었습니다.
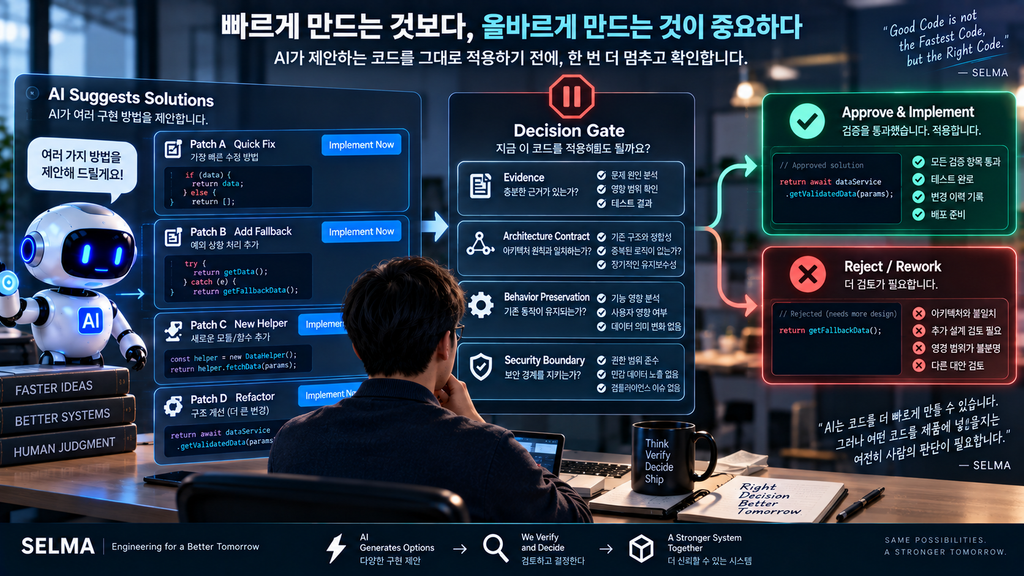
대부분의 경우 AI는 해결 방법을 제시했습니다.
문제가 발생하면 새로운 Helper를 만들 수도 있습니다.
Fallback을 추가할 수도 있습니다.
기존 구조를 확장하거나 새로운 Interface를 만드는 방법도 제안합니다.
문제는 그다음입니다.
그중 어떤 해결 방법을 선택해야 하는가?
빠르게 동작하는 방법과 Architecture에 맞는 방법이 항상 같지는 않았습니다.
오류를 없애는 Patch가 장기적으로 두 번째 Source of Truth를 만들 수도 있고, 사용자 경험을 좋아 보이게 만드는 Fallback이 실제 결함을 가릴 수도 있었습니다.
AI가 선택지를 만드는 속도가 빨라질수록 어떤 선택을 허용할 것인지 결정하는 역할이 더 중요해졌습니다.

실제로 가장 어려웠던 것은 코드가 아니었다
SELMA Architecture Hardening 과정에서 반복해서 이런 질문을 만났습니다.
이 의미는 LLM이 판단해야 할까, Contract가 결정해야 할까?
Contract에 없는 정보를 Runtime이 추측해도 될까?
Permission Scope를 적용하기 위해 JOIN을 추가했을 때 데이터 Grain이 바뀌면 허용할 수 있을까?
오래된 Fallback을 제거했는데 기능이 깨졌다면 Fallback을 복원해야 할까, 아니면 그 아래의 Architecture Gap을 수정해야 할까?
사용자가 요청한 의미를 시스템이 표현하지 못하면 가장 비슷한 답을 보여줘야 할까, 아니면 되물어야 할까?
이런 문제에는 단순한 문법적 정답이 없습니다.
각 선택이 제품의 행동과 Architecture의 경계를 결정합니다.
AI가 코드를 작성해줄 수 있어도 “SELMA는 어떤 시스템이어야 하는가?”라는 질문까지 자동으로 위임할 수는 없었습니다.
가장 빠른 해결책이 틀린 해결책일 수도 있었다
Permission Scope 문제를 수정할 때도 비슷한 경험을 했습니다.
특정 Query에서 SQL Alias가 잘못된 위치에서 사용되어 데이터베이스 오류가 발생했습니다.
가장 간단한 해결책은 조건문의 위치를 옮기는 것이었습니다.
SQL Error는 사라질 수 있습니다.
하지만 자세히 보면 문제가 있었습니다.
조건을 LEFT JOIN 바깥의 WHERE로 옮기면 데이터가 없는 기간의 행 자체가 사라질 수 있었습니다.
오류는 없어지지만 분석 결과의 의미가 바뀌는 것입니다.
결국 단순 Patch를 선택하지 않았습니다.
왜 Permission의 의미가 특정 SQL Alias에 묶여 있는지부터 다시 조사했고, Scope를 Semantic Dimension으로 선언한 뒤 각 Query가 자신의 구조에서 안전하게 Binding하도록 Architecture를 변경했습니다.
이 과정에서 중요했던 판단은
“어떻게 하면 이 SQL Error를 없앨 수 있는가?”
가 아니라,
“어떤 수정이 시스템의 의미를 바꾸지 않는가?”
였습니다.
AI가 만든 코드를 거절하는 것도 개발자의 일이었다
AI 코딩에서는 생성된 코드가 자연스럽고 완성도가 높아 보일 때가 많습니다.
그래서 그대로 받아들이고 싶은 유혹도 있습니다.
하지만 SELMA를 개발하면서 코드를 작성하는 능력만큼 코드를 거절하는 능력도 중요하다고 느꼈습니다.
실제로 조사 과정에서 여러 선택지가 나왔지만 바로 구현하지 않고 멈춘 경우가 많았습니다.
Contract Schema를 넓혀야 하는가?
도달하지 않는 Legacy Path를 위해 새로운 Declaration을 만들어야 하는가?
권한을 표현하기 위해 새로운 Semantic Dimension이 필요한가?
기존 동작을 유지해야 하는가, 아니면 Capability 자체를 바꿔야 하는가?
Architecture Decision이 필요한 경우에는 Implementation을 중단하고 먼저 근거를 조사했습니다.
AI가 코드를 빠르게 만들 수 있다는 이유로 결정되지 않은 설계를 코드로 먼저 확정하지 않기 위해서였습니다.
무엇을 고칠지보다 무엇을 고치지 않을지도 중요했다
Repository를 Audit하면 개선할 부분은 계속 발견됩니다.
Dead Code가 있습니다.
Minor Debt도 있습니다.
더 깔끔하게 만들 수 있는 Interface도 있습니다.
아직 구현하지 않은 Capability도 보입니다.
하지만 발견한 모든 것을 즉시 수정하면 Architecture Hardening은 끝나지 않습니다.
SELMA에서는 Finding을 Critical, High, Medium, Low, Known Constraint, Capability Gap 등으로 구분했습니다.
그리고 영향 범위가 명확하고 현재 사용자에게 잘못된 답을 만들지 않는 문제라면 알고 있는 상태로 남겨두기도 했습니다.
이것도 하나의 Engineering Decision이었습니다.
완벽한 Repository를 만드는 것이 목적이 아니라 현재 단계에서 신뢰할 수 있는 시스템을 만들고 다음 단계로 이동하는 것이 목적이기 때문입니다.
언제 멈출지도 사람이 결정해야 했다
AI에게 계속 질문할 수 있습니다.
“다른 문제는 없어?”
그러면 새로운 개선점이 계속 나올 수 있습니다.
하지만 실제 개발에서는 언젠가 배포하고 사용자를 만나야 합니다.
그래서 SELMA에는 Exit Gate를 만들었습니다.
Critical 0.
High 0.
핵심 Invariant Clean.
Regression Stable.
Break-to-Red 확인.
Blueprint와 Repository 일치.
설명되지 않는 Product Failure 0.
이 조건을 만족한 뒤에야 Alpha Architecture Hardening을 완료했다고 판단했습니다.
중요한 것은 AI가
“이제 완벽합니다.”
라고 말하는 것이 아니었습니다.
우리가 어떤 Evidence가 쌓이면 다음 단계로 넘어가겠다고 미리 정하는 것이었습니다.
그런데 사람이 첫 질문에서 또 문제를 발견했다
Hardening을 완료한 뒤 SELMA 사이트를 직접 사용했습니다.
그리고 아주 평범하게 물었습니다.
“올해 8월 매출 분석해줘.”
SELMA는 정확한 숫자를 알려줬지만 분석하지 않았습니다.
다음에는
“내가 볼 수 있는 데이터는 어떤 것들이 있지?”
라고 물었습니다.
이번에는 Capability Discovery라는 질문 종류가 시스템에 없다는 사실이 드러났습니다.
Architecture Test가 잘못됐다는 뜻은 아니었습니다.
테스트하지 않았던 새로운 Product Semantics가 실제 사용에서 발견된 것입니다.
그래서 개발자의 역할에는 또 하나가 추가됐습니다.
직접 사용자가 되어 시스템을 의심하는 것.
AI 시대 개발자는 무엇을 하게 될까?
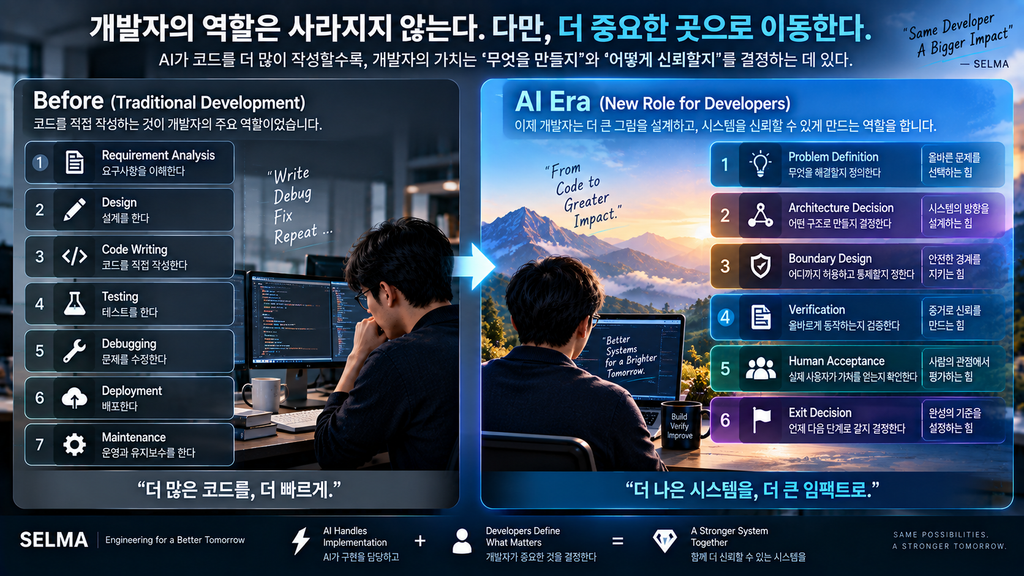
AI가 발전할수록 개발자가 직접 작성하는 코드의 비율은 계속 줄어들 수도 있습니다.
그렇다고 개발자가 시스템에서 멀어지는 것은 아닐 수 있습니다.
오히려 AI가 더 많은 Implementation을 담당할수록 개발자는 다음과 같은 질문을 더 많이 다루게 될 가능성이 있습니다.
무엇을 만들 것인가?
어디까지 AI에게 맡길 것인가?
어떤 의미는 Contract가 소유해야 하는가?
어떤 Boundary는 절대로 넘어서는 안 되는가?
무엇을 근거로 이 시스템을 신뢰할 것인가?
언제 충분히 검증됐다고 판단할 것인가?
이런 판단을 하려면 여전히 코드를 이해해야 합니다.
SQL이 어떻게 동작하는지, Transaction이 무엇인지, Permission이 어디에서 깨질 수 있는지, Test가 무엇을 증명하는지 알아야 AI의 결과를 평가할 수 있기 때문입니다.
그래서 저는 AI 시대의 개발자를 단순히 코드를 덜 작성하는 개발자라고 생각하지 않습니다.
오히려 역할의 중심이 이동하는 것에 가깝다고 생각합니다.
From writing every line
to defining what every line must never violate.
AI가 키보드를 가져갈수록 판단의 가치가 커질 수 있다
SELMA를 만들면서 제가 직접 타이핑한 코드의 양은 이전 방식보다 줄었습니다.
하지만 Architecture와 Product에 대해 생각하는 시간은 줄지 않았습니다.
오히려 더 많아졌습니다.
AI가 구현을 빠르게 만들었기 때문에 더 많은 가능성을 짧은 시간 안에 검토해야 했습니다.
그리고 최종적으로 어떤 시스템을 만들 것인지 결정하는 책임은 여전히 남았습니다.
그래서 이 Engineering Notes 시리즈를 마무리하며 지금의 생각을 한 문장으로 정리한다면 이렇습니다.
AI가 개발자에게서 키보드를 조금씩 가져갈수록,
개발자의 가장 중요한 도구는 판단이 될지도 모릅니다.
AI가 코드를 얼마나 많이 작성할 수 있는가는 앞으로 더 이상 놀라운 일이 아닐 수도 있습니다.
그다음 질문은 아마 이것일 것입니다.
AI가 만든 수많은 선택 중 무엇을 제품에 넣을 것인가.
그리고 그 선택을 어떤 원칙과 Evidence로 설명할 수 있는가.
SELMA를 개발하면서 저는 그 부분이 앞으로의 AI Engineering에서 점점 더 중요해질 것이라고 느끼고 있습니다.
#AI시대개발자 #AI코딩 #바이브코딩 #개발자역할 #AIEngineering #소프트웨어아키텍처 #ArchitectureDecision #ArchitectureInvariant #EnterpriseAI #AI에이전트 #소프트웨어개발 #SELMA