
핵심 키워드: Business Meaning, Data Contract, Enterprise AI, LLM, AI 데이터 분석, 데이터 거버넌스, Semantic Layer, SELMA

앞선 글에서는 AI가 실제 데이터에서 가져온 정확한 숫자로도 틀린 답을 할 수 있는 이유를 살펴봤습니다.
이 문제를 따라가다 보면 결국 한 가지 질문에 도착합니다.
기업에서 ‘매출’, ‘고객’, ‘주문’, ‘해지’ 같은 업무 용어의 의미는 누가 결정해야 할까?
LLM이 데이터베이스 Schema를 보고 판단하게 할 수도 있습니다.
개발자가 Runtime 코드에 규칙을 넣을 수도 있습니다.
하지만 개인 프로젝트 SELMA를 개발하면서 저는 두 방법 모두 장기적으로 문제가 생길 수 있다고 생각했습니다.
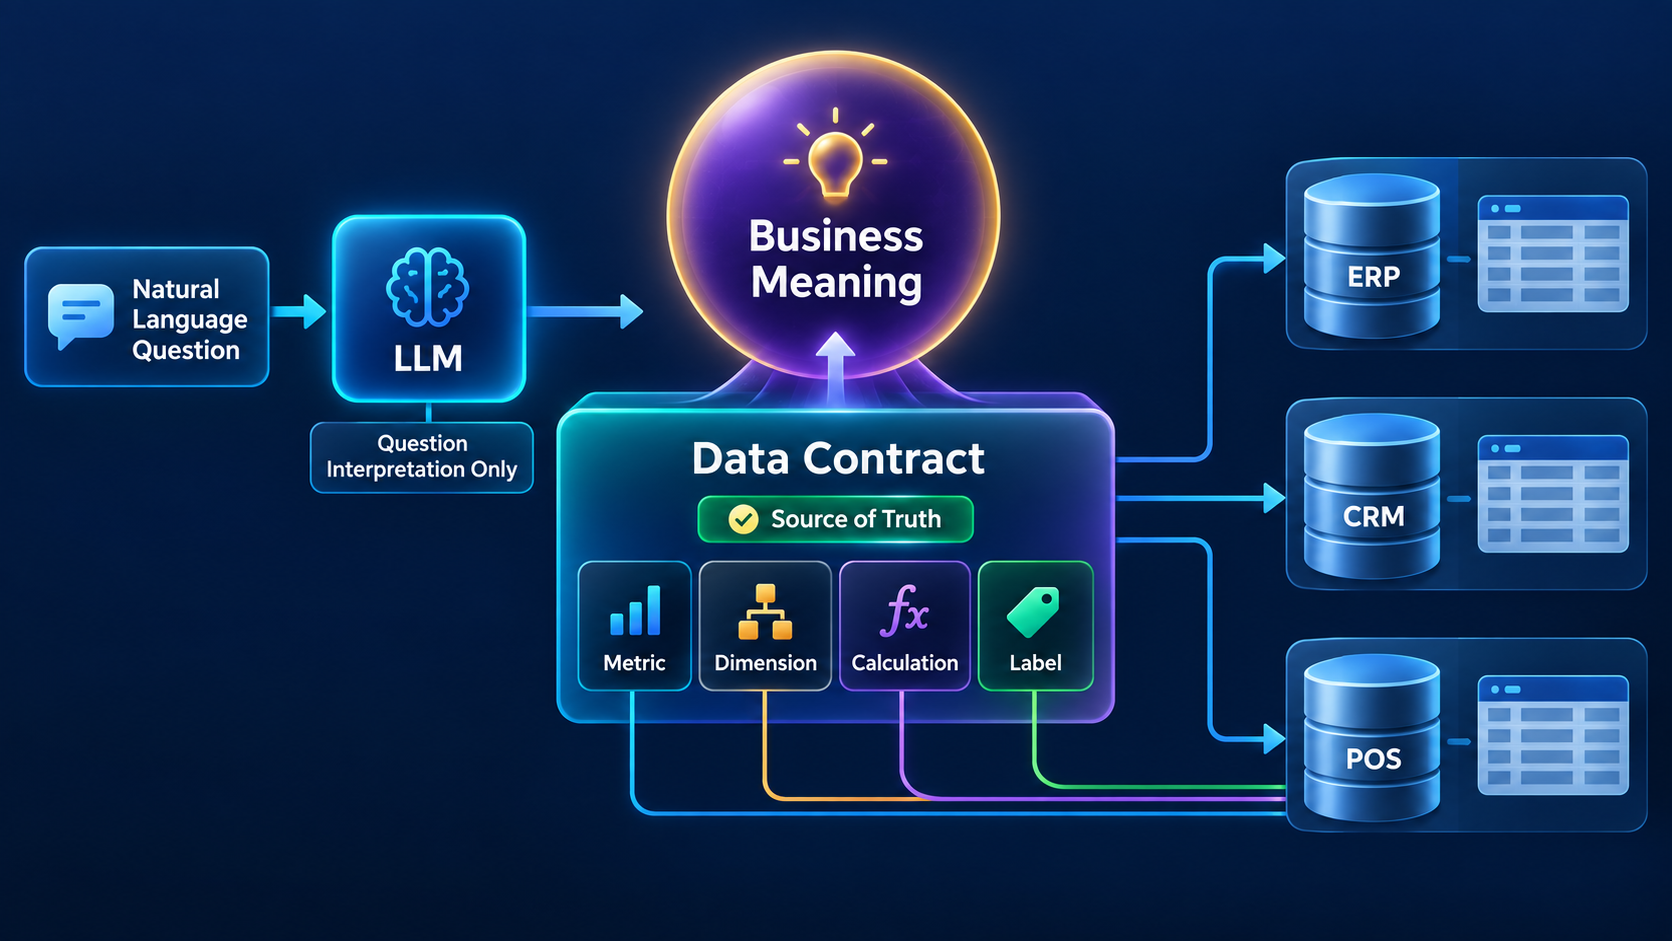
그래서 SELMA에서는 Business Meaning의 Source of Truth를 Contract에 두는 방향을 선택했습니다.
같은 ‘매출’도 회사마다 의미가 다르다
매출이라는 단어는 누구나 알고 있는 것처럼 보입니다.
하지만 실제 기업 데이터에서는 그렇지 않습니다.
한 회사에서는 결제 완료 금액을 매출이라고 부를 수 있습니다.
다른 회사에서는 할인과 환불을 제외한 금액을 사용할 수도 있습니다.
제약 CRM에서는 처방액이 핵심 지표가 될 수 있고, 고객 케어 시스템에서는 해지 월요금이 중요한 지표가 될 수 있습니다.
즉 Runtime이
revenue = 이 컬럼
이라고 알고 있어서는 안 됩니다.
새로운 고객이 들어올 때마다 코드를 수정해야 하고, 특정 산업에서 만든 의미가 다른 고객에게 흘러갈 수도 있기 때문입니다.
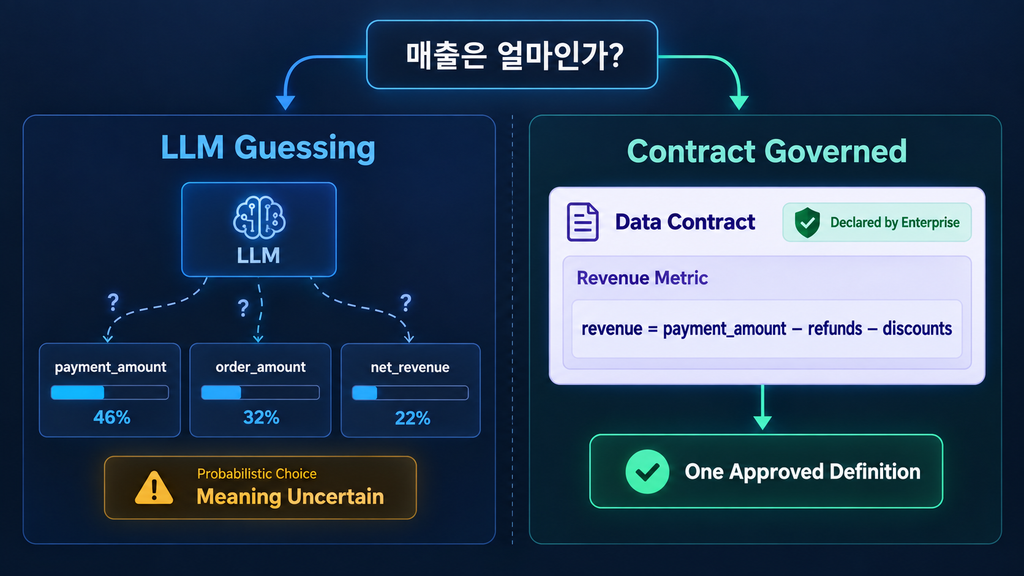
LLM에게 의미를 판단하게 하면 안 될까?
LLM은 자연어 이해에 매우 강합니다.
매출, 판매액, revenue 같은 표현이 비슷한 의미라는 것도 잘 이해합니다.
하지만 비슷한 의미라는 것과 기업에서 공식적으로 같은 지표라는 것은 다른 문제입니다.
예를 들어 데이터베이스에 다음 컬럼이 있다고 해보겠습니다.
payment_amountorder_amountdiscount_amountrefund_amount
LLM은 이름과 주변 정보를 이용해 가장 가능성이 높은 계산을 추론할 수 있습니다.
문제는 기업에서는 “가능성이 높다”만으로 부족하다는 것입니다.
이번에는 맞았더라도 모델이 바뀌거나 Schema가 달라졌을 때 같은 의미가 유지된다는 보장이 필요합니다.
그래서 SELMA에서는 LLM이 업무의 의미를 소유하지 않도록 했습니다.
Contract에는 무엇이 들어갈까?
SELMA에서 Contract는 단순히 데이터베이스 연결 정보를 저장하는 설정 파일이 아닙니다.
기업이 데이터를 어떤 업무 의미로 사용할 것인지 선언하는 역할을 합니다.
예를 들면 다음과 같은 정보입니다.
Metric
무엇을 측정하는가
Dimension
어떤 기준으로 나누어 볼 수 있는가
Label
사용자 화면에서 어떤 업무 용어로 보여줄 것인가
Calculation
어떤 데이터와 계산 규칙을 사용하는가
Capability
해당 데이터로 어떤 종류의 분석을 수행할 수 있는가
이렇게 하면 LLM은 사용자가 매출을 물었다는 것을 해석할 수 있지만,
그 매출을 실제로 어떻게 계산할지는 Contract가 결정합니다.
Source of Truth가 두 개면 어떤 일이 생길까?
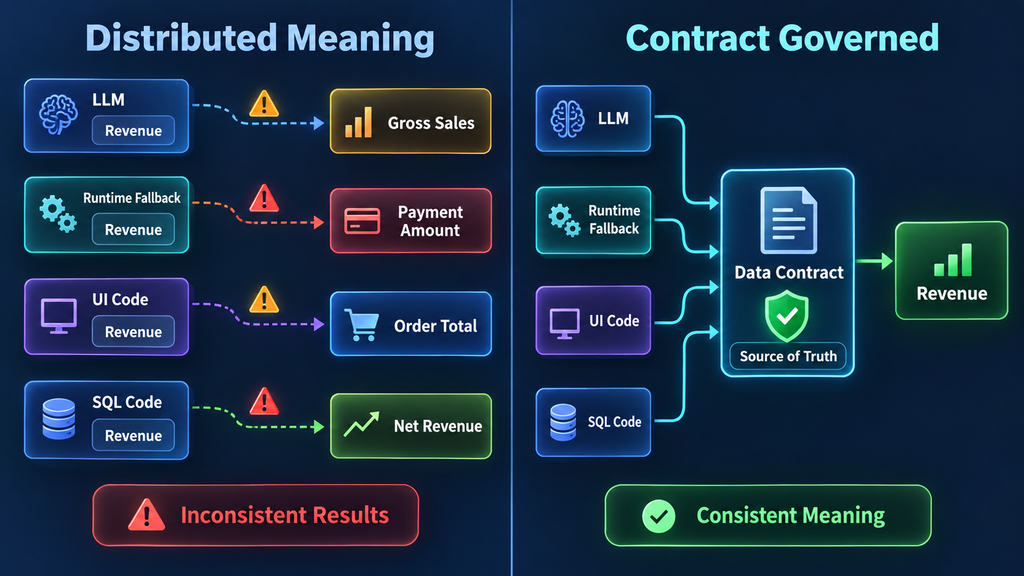
SELMA의 Architecture Hardening 과정에서 반복해서 발견한 문제가 바로 이것이었습니다.
같은 의미를 두 곳이 판단하고 있었습니다.
Contract가 Metric을 정의하고 있는데 Runtime에도 이름 기반 fallback이 존재하거나, 사용자에게 보여줄 Label이 Contract에 있는데 별도의 코드가 다시 이름을 만드는 식입니다.
처음에는 두 곳이 같은 결과를 내기 때문에 문제가 없어 보입니다.
하지만 한쪽만 수정되는 순간 결과가 갈라집니다.
그래서 SELMA에서는 다음 원칙을 중요하게 보고 있습니다.
One semantic decision, one authority.
같은 판단을 두 곳에서 하지 않는다는 의미입니다.
하나가 틀렸을 때 한 곳만 수정하면 전체 시스템이 같은 의미를 사용하도록 만드는 것이 목표입니다.
Contract가 없으면 어떻게 해야 할까?
여기서 또 중요한 선택이 생깁니다.
사용자가 물어본 의미를 Contract가 표현하지 못하면 어떻게 해야 할까요?
가장 가까운 Metric을 찾아 대신 답할 수도 있습니다.
하지만 SELMA에서는 점점 반대 방향을 선택하게 됐습니다.
Contract가 말하지 않는다면 Runtime도 새로운 Business Meaning을 만들어내지 않는다.
필요하다면 사용자에게 되묻습니다.
또는 현재 데이터에서는 해당 질문을 정확하게 표현할 수 없다고 알려줍니다.
처음에는 답변율이 떨어지는 것처럼 보일 수 있습니다.
하지만 Enterprise AI에서는 틀린 의미로 자신 있게 답하는 것보다 무엇이 부족한지를 명확하게 드러내는 것이 더 중요할 수 있다고 생각합니다.
더 좋은 AI보다 흔들리지 않는 의미
SELMA를 개발하면서 LLM의 성능이 중요하지 않다고 생각하게 된 것은 아닙니다.
오히려 모델이 좋아질수록 자연어 질문을 이해하고 결과를 설명하는 능력은 계속 좋아질 것입니다.
하지만 모델 성능과 Business Meaning은 분리할 필요가 있습니다.
오늘 사용하는 LLM을 내일 더 좋은 모델로 바꾸더라도,
기업이 정의한 ‘매출’의 의미까지 바뀌어서는 안 됩니다.
그래서 SELMA에서는 AI의 유연함 위에 기업의 의미를 고정하는 Contract Layer를 두고 있습니다.
저는 이것이 Enterprise AI에서 필요한 Governance의 중요한 부분이라고 생각합니다.
AI는 질문을 이해할 수 있다.
하지만 기업의 진실은 기업이 선언해야 한다.
다음 7편에서는 Business Meaning만큼 중요한 또 하나의 경계를 살펴보겠습니다. 사용자가 볼 수 있는 데이터 범위를 단순히 화면에서 제한하는 것이 아니라 Permission Scope를 실제 SQL 실행까지 어떻게 유지했는지, SELMA의 권한 관리 구조와 실제 검증 경험을 정리해보겠습니다.
#BusinessMeaning #DataContract #EnterpriseAI #엔터프라이즈AI #SemanticLayer #LLM #AI데이터분석 #데이터거버넌스 #AIGovernance #AI에이전트 #소프트웨어아키텍처 #SELMA