
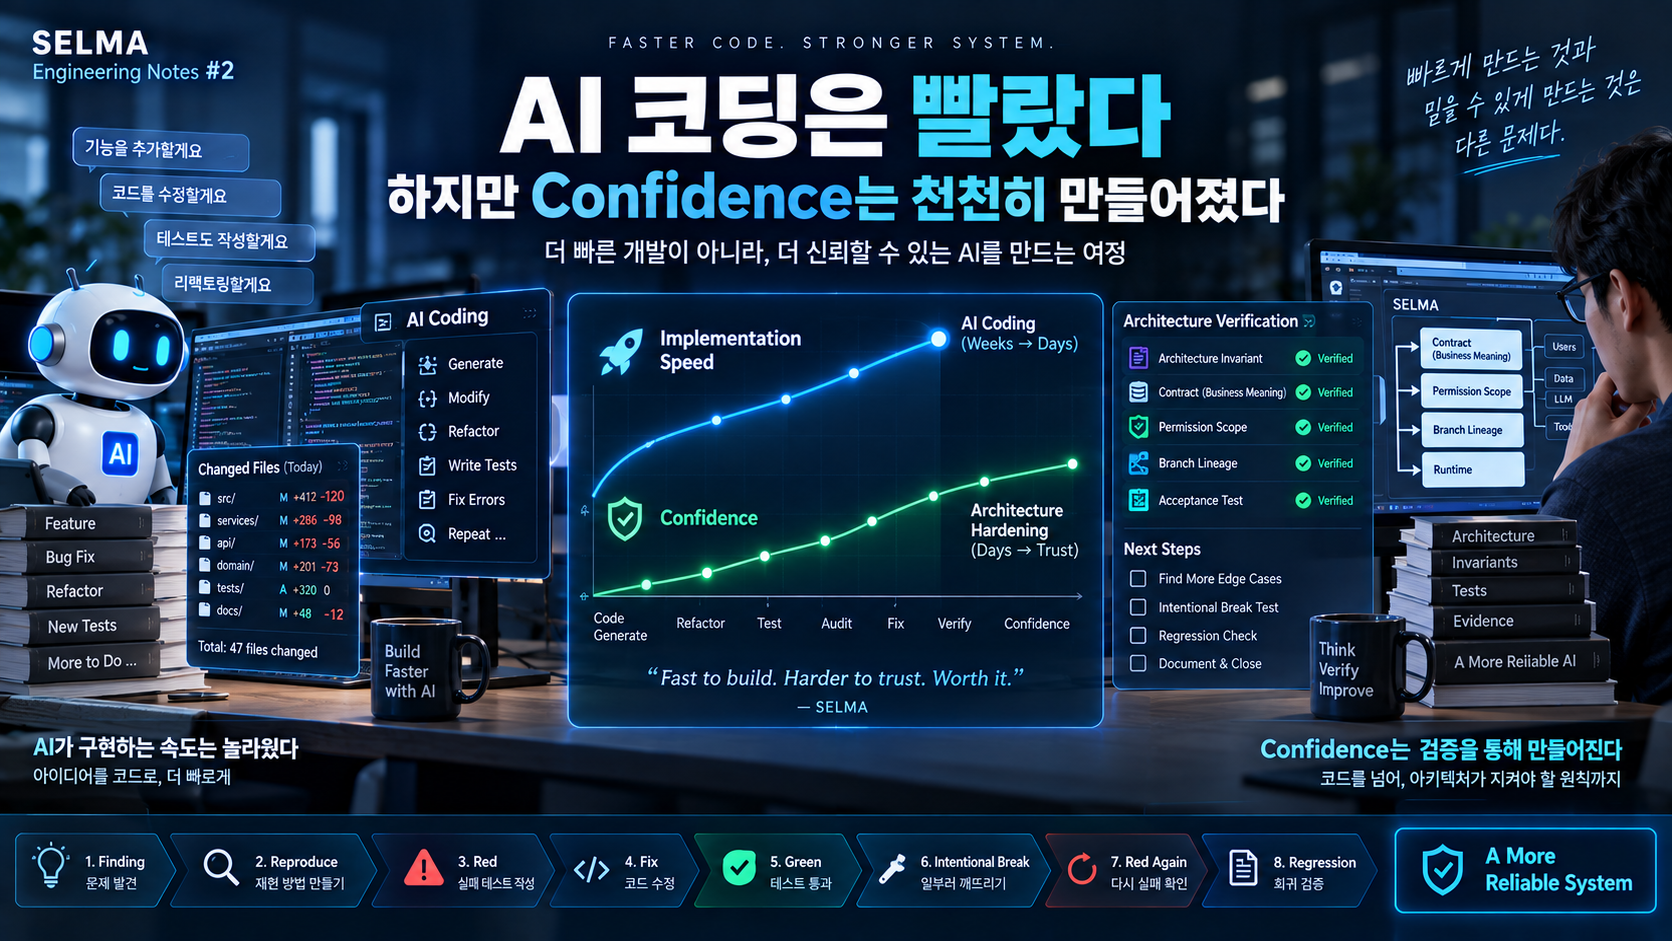
핵심 키워드: AI 코딩, AI 리팩토링, 바이브 코딩, AI 코드 검증, Architecture Hardening, 소프트웨어 아키텍처, SELMA
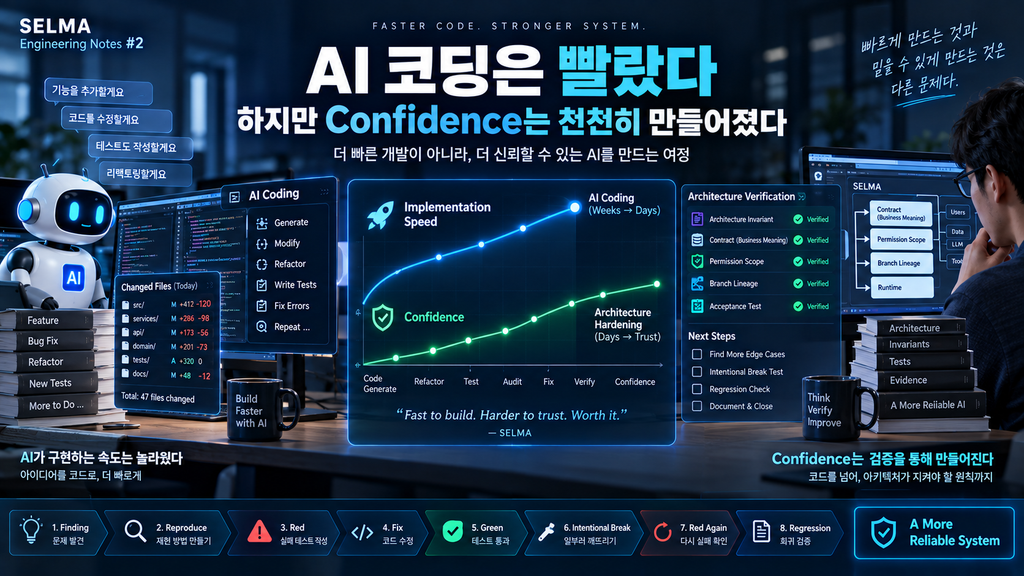
AI 코딩을 사용하면 개발 속도가 얼마나 빨라질까요?
개인 프로젝트 SELMA를 개발하면서 이 질문을 직접 경험하고 있습니다.
새로운 기능을 구현하는 속도만 보면 놀라울 정도였습니다.
Repository를 조사하고 코드를 수정하고 테스트를 추가하는 작업까지 AI와 함께 진행할 수 있었습니다.
그래서 SELMA의 Architecture를 본격적으로 정리하기 시작했을 때도 처음에는 오래 걸리지 않을 것이라고 생각했습니다.
문제를 찾았고, 수정할 방향도 알고 있었습니다.
AI가 구현하고 다시 AI가 검증하면 빠르게 끝날 것 같았습니다.
하지만 실제로는 달랐습니다.
코드를 수정하는 시간보다 수정한 Architecture를 믿을 수 있는 상태로 만드는 시간이 훨씬 오래 걸렸습니다.
처음에는 단순한 리팩토링이라고 생각했다
SELMA에는 프로젝트가 발전하면서 과거 방식의 코드가 일부 남아 있었습니다.
처음에는 이런 코드를 찾아 제거하고 Source of Truth를 하나로 합치면 된다고 생각했습니다.
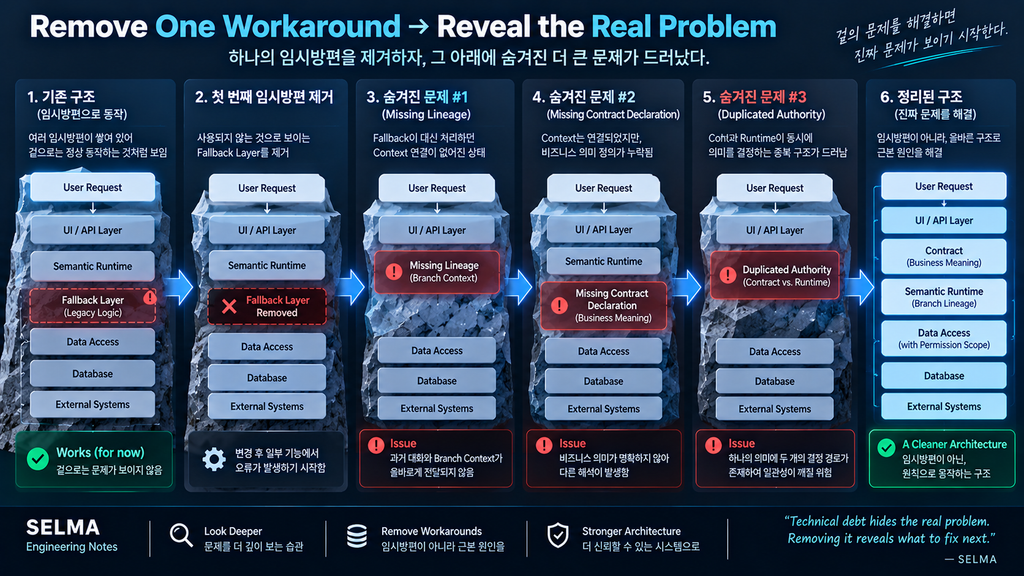
예를 들어 Contract가 Business Meaning을 결정한다면 이름을 보고 다시 추측하는 Runtime Fallback은 제거합니다.
Branch Lineage가 Context의 기준이라면 Session의 최근 대화를 다시 읽는 로직은 없앱니다.
구조만 보면 단순합니다.
그런데 오래된 코드를 하나 제거하자 예상하지 못했던 기능이 깨졌습니다.
조사해보니 해당 코드는 단순한 중복이 아니었습니다.
Architecture에서 빠져 있던 부분을 몰래 보상하고 있었습니다.
즉 기술부채를 제거하자 그 아래 숨어 있던 또 다른 기술부채가 나타난 것입니다.
Dead Code라고 생각했는데 실제로 사용 중이었다
리팩토링 과정에서 위험했던 경험도 있었습니다.
Repository를 조사해 호출처가 없는 함수들을 찾았습니다.
정적 검색 결과만 보면 사용되지 않는 Dead Code처럼 보였습니다.
그래서 여러 함수를 제거했습니다.
그런데 Planner에서 사용하던 Tool들이 통째로 사라졌습니다.
원인은 Dynamic Registry였습니다.
함수를 코드에서 직접 호출하지 않고 Resource에 기록된 이름과 Runtime Registry를 통해 찾아 사용하는 구조였기 때문입니다.
검색 결과는 caller 0이었지만 실제 실행에서는 사용되고 있었습니다.
즉,
No caller ≠ Dead code
였습니다.
바로 변경을 되돌리고 Dynamic Dispatch와 Registry까지 포함해 다시 조사했습니다.
이 경험 이후 AI에게 “사용하지 않는 코드를 찾아 삭제해줘”라고 바로 맡기는 방식은 사용하지 않게 됐습니다.
먼저 왜 사용되지 않는다고 판단했는지 증명하는 과정이 필요했습니다.
하나의 결함이 다른 결함을 가리고 있었다
Architecture Hardening이 길어진 또 다른 이유는 결함이 계층적으로 숨어 있었기 때문입니다.
예를 들어 Permission Scope 문제를 수정하면서 특정 고객 데이터의 분석 Tool이 계속 실패하는 현상을 발견했습니다.
처음에는 권한 조건이 잘못된 위치에 붙어 있는 SQL 문제처럼 보였습니다.
하지만 조사 범위를 넓히자 실제 원인은 더 깊었습니다.
Permission의 의미를 region 같은 Semantic Dimension이 아니라 j3.region처럼 특정 SQL Query에서만 유효한 물리 Alias가 소유하고 있었습니다.
한 Query에서는 정상입니다.
다른 형태의 Query에서는 j3가 아직 만들어지지 않았거나 아예 존재하지 않을 수 있습니다.
결국 SQL 한 줄을 옮기는 것으로 해결하지 않았습니다.
권한의 의미를 Contract로 끌어올리고 Runtime이 각 Query Shape에서 안전하게 Scope를 Binding하도록 구조 자체를 변경했습니다.
작은 버그 하나가 실제로는 Architecture Boundary가 잘못된 증거였던 것입니다.
그래서 수정 전에 Red를 먼저 만들었다
작업 방식도 점점 바뀌었습니다.
처음에는 문제를 발견하면 바로 코드를 수정했습니다.
나중에는 먼저 해당 문제를 재현하는 Acceptance Test를 만들었습니다.
수정 전에는 반드시 Red여야 합니다.
그다음 구현을 변경해 Green으로 만듭니다.
여기서도 끝내지 않았습니다.
일부러 이전의 잘못된 Architecture를 복원했습니다.
그리고 다시 Red가 되는지 확인했습니다.
이렇게 한 이유는 단순합니다.
Green Test 자체도 잘못 작성될 수 있기 때문입니다.
테스트가 통과한다는 사실이 아니라 깨뜨렸을 때 정확한 이유로 실패하는지까지 확인해야 해당 Invariant를 실제로 보호한다고 판단할 수 있었습니다.

AI가 AI를 검증하면 자동으로 안전해질까?
이번 작업에서는 구현과 검증 모두 AI를 적극적으로 활용했습니다.
한 AI가 수정 방향을 조사하고 코드를 변경합니다.
다시 Repository 전체를 검색합니다.
Acceptance를 만들고 Regression을 실행합니다.
필요하면 다른 관점에서 다시 Architecture를 Audit합니다.
이 방식은 확실히 빨랐습니다.
하지만 중요한 사실도 발견했습니다.
AI가 만든 코드를 다른 AI가 검토한다고 해서 검증 기준까지 자동으로 독립되는 것은 아닙니다.
둘 다 같은 Repository와 같은 기존 Test를 보고 같은 Architecture Assumption을 받아들이면 함께 잘못된 결론에 도달할 수 있습니다.
그래서 검증 기준을 AI의 판단 밖에 두려고 했습니다.
Architecture Invariant와 Contract, Red Acceptance가 그 역할을 했습니다.
AI는 구현하고 조사할 수 있습니다.
하지만 무엇이 올바른 Architecture인지 판단할 기준은 먼저 고정되어 있어야 했습니다.
가장 어려웠던 것은 언제 끝났다고 말할 것인가였다
AI에게 Repository를 계속 조사시키면 개선할 부분은 계속 발견됩니다.
중복 함수도 있습니다.
더 좋은 추상화도 있습니다.
테스트를 추가할 수도 있고 미래 기능을 미리 설계할 수도 있습니다.
그러면 리팩토링은 끝나지 않습니다.
그래서 SELMA Architecture Hardening에는 Exit Gate를 두었습니다.
Critical과 High Finding이 남아 있는가.
핵심 Architecture Invariant가 깨져 있는가.
Acceptance에서 설명되지 않는 Product Failure가 존재하는가.
남은 Medium과 Low Finding의 영향 범위가 명확한가.
일부러 Invariant를 깨뜨렸을 때 Test가 실제로 Red가 되는가.
Blueprint와 Repository가 같은 Architecture를 말하고 있는가.
이 기준을 만족해야 비로소 다음 단계로 넘어가도록 했습니다.
즉 개발자가 해야 할 중요한 판단은
“더 고칠 것이 있는가?”
가 아니라,
“어떤 조건이면 지금의 시스템을 충분히 신뢰하고 다음 단계로 넘어갈 것인가?”
였습니다.
7일 동안 가장 많이 만든 것은 코드가 아니었다
돌이켜보면 Architecture Hardening 기간 동안 코드도 상당히 많이 바뀌었습니다.
하지만 가장 중요한 결과물은 새로운 기능이 아니었습니다.
Confidence를 만들기 위한 근거였습니다.
어떤 의미가 어디에서 결정되는지 알 수 있게 됐습니다.
권한이 실제 SQL까지 보존되는지 검사할 수 있게 됐습니다.
Branch Context가 Session Chronology에 오염되는 경로를 막았습니다.
잘못된 구조가 다시 들어오면 Red가 되는 Acceptance를 만들었습니다.
그리고 남은 한계를 Known Constraint로 구분할 수 있게 됐습니다.
AI가 Implementation을 빠르게 만드는 시대에는 이런 작업의 중요성이 오히려 커질 수 있다고 생각합니다.
Code generation can be fast.
Architectural confidence still has to be earned.
AI는 코드를 매우 빠르게 만들었습니다.
하지만 그 코드가 하나의 Architecture 안에서 올바르게 동작한다는 신뢰는 조사하고, 깨뜨리고, 검증하면서 조금씩 만들어야 했습니다.
그래서 SELMA를 약 7일 동안 리팩토링하며 얻은 결론은 단순했습니다.
AI 코딩의 속도와 소프트웨어를 신뢰할 수 있게 되는 속도는 같지 않았습니다.
다음 Engineering Notes 3편에서는 여기서 더 흥미로운 문제를 다뤄보겠습니다.
「Tests Are Green, Architecture Is Wrong」
코드와 테스트가 모두 정상인데 어떻게 시스템 전체는 틀릴 수 있었는지, 그리고 AI가 Implementation과 Test를 함께 만드는 환경에서 왜 이 문제가 더 중요해질 수 있는지 집중적으로 정리해보겠습니다.
#AI코딩 #AI리팩토링 #바이브코딩 #ArchitectureHardening #AI코드검증 #AIEngineering #소프트웨어아키텍처 #ArchitectureInvariant #리팩토링 #EnterpriseAI #개발자 #SELMA