

핵심 키워드: AI 코딩, 바이브 코딩, Architecture Invariant, AI 테스트, 소프트웨어 아키텍처, Enterprise AI, SELMA
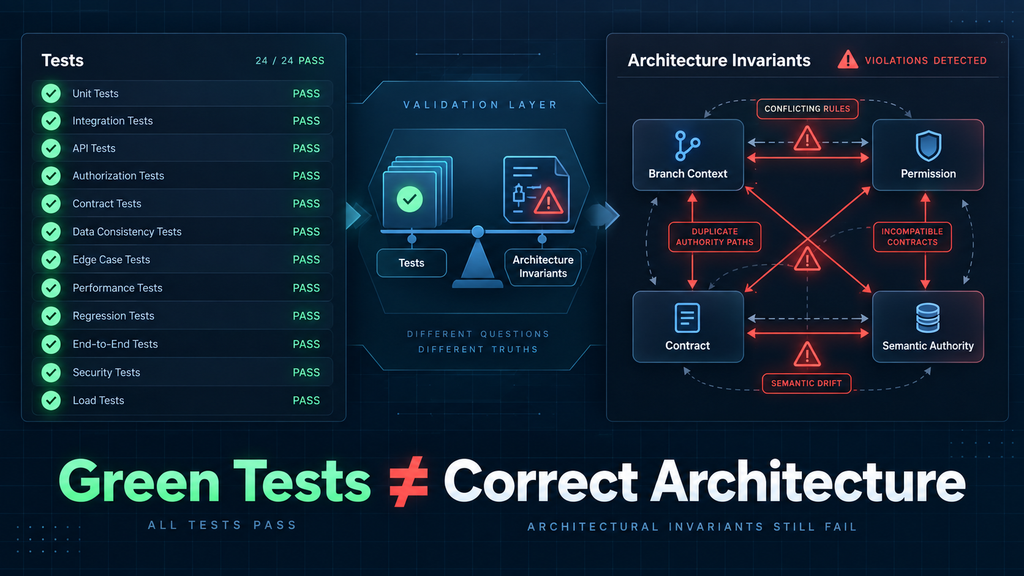
AI 코딩과 바이브 코딩을 사용하면 코드를 만드는 속도가 상당히 빨라집니다.
기능 구현뿐 아니라 테스트 코드도 AI가 빠르게 작성할 수 있습니다.
저 역시 개인 프로젝트 SELMA를 개발하면서 많은 부분을 AI와 함께 구현하고 테스트했습니다.
기능이 늘어나면서 테스트도 계속 추가했습니다.
테스트 결과가 모두 Green이라면 시스템이 꽤 안정적이라고 생각하기 쉽습니다.
저도 처음에는 그렇게 생각했습니다.
그런데 실제 사용 중 예상하지 못한 문제를 발견했습니다.
테스트는 모두 통과하고 있었지만 Architecture는 올바르지 않았습니다.
Branch를 선택했는데 다른 대화가 섞였다
SELMA는 처음에는 일반적인 Linear Conversation 구조로 시작했습니다.
사용자가 질문하고 답을 받은 뒤 다음 질문을 이어가는 일반적인 대화 방식입니다.
이후 SELMA의 분석 구조를 확장했습니다.
과거 분석의 특정 지점을 선택하고 그 시점부터 새로운 분석을 시작할 수 있도록 Workspace → Analysis → Branch 구조로 변경했습니다.
예를 들어 사용자가 8월 매출을 분석하다가 한쪽 Branch에서는 상품별 원인을 살펴보고, 다른 Branch에서는 지역별 분석을 이어갈 수 있는 구조입니다.
UI도 Branch를 알고 있었습니다.
Database의 Persistence Model 역시 Branch를 저장했습니다.
그런데 실제로 과거 Branch를 선택한 뒤 질문했을 때 가끔 전혀 다른 Context의 답이 나왔습니다.
원인을 조사해보니 일부 Semantic Runtime이 여전히 세션에서 시간상 가장 최근의 대화를 Context로 사용하고 있었습니다.

그런데 왜 테스트는 모두 Green이었을까?
이 부분이 가장 흥미로웠습니다.
문제는 Production 코드에만 있었던 것이 아닙니다.
테스트 역시 비슷한 가정을 하고 있었습니다.
개발 과정에서 만든 테스트는 대부분 질문을 시간 순서대로 진행했습니다.
그러니 “가장 최근 대화를 읽는다”는 Runtime의 잘못된 가정과 테스트의 사용 방식이 우연히 일치했습니다.
코드는 일관됐습니다.
테스트도 정확하게 그 코드를 검증했습니다.
결과는 모두 Green이었습니다.
하지만 실제 제품이 지켜야 하는 Architecture와는 달랐습니다.
이 경험을 한 문장으로 표현하면 다음과 같습니다.
The code is consistent.
The tests are green.
The architecture is still wrong.
Tests와 Architecture Invariant는 질문이 다르다
일반적인 기능 테스트는 보통 이런 질문을 합니다.
“이 입력을 넣었을 때 기대한 결과가 나오는가?”
매우 중요하고 필요한 검증입니다.
하지만 Architecture 관점에서는 다른 질문도 필요했습니다.
“어떤 실행 경로를 지나더라도 시스템이 절대로 깨뜨려서는 안 되는 것은 무엇인가?”
그래서 SELMA에서는 이를 Architecture Invariant로 정리하기 시작했습니다.
예를 들면 다음과 같습니다.
- LLM은 Authoritative SQL을 직접 생성하지 않는다.
- Business Meaning은 Contract에서 온다.
- Permission Scope는 실제 SQL 실행까지 보존된다.
- Semantic Context는 Session Chronology가 아니라 선택한 Branch Lineage를 따른다.
- 같은 의미에는 하나의 Source of Truth만 존재한다.
- Analytical Claim은 Evidence보다 강할 수 없다.
이것들은 특정 질문 하나가 잘 동작하는지를 검사하는 규칙이 아닙니다.
SELMA가 어떤 기능을 추가하더라도 계속 지켜야 하는 시스템의 약속입니다.
Repository 전체를 다시 Audit했다
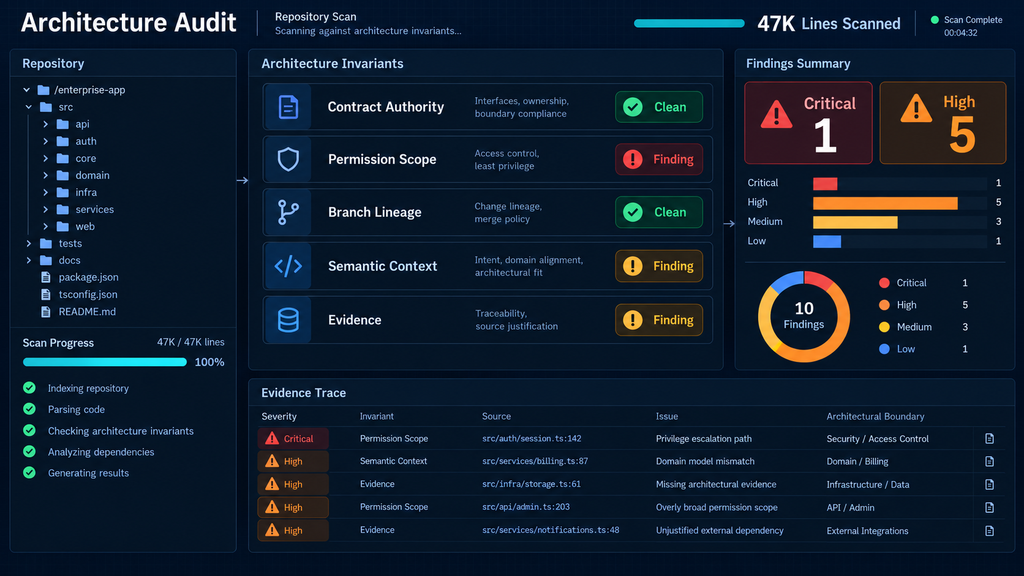
Invariant를 정의한 뒤 SELMA Repository 전체를 다시 조사했습니다.
당시 약 47K lines의 코드를 대상으로 Architecture Audit을 진행했고 13개의 Finding을 발견했습니다.
그중에는 Critical 1개와 High 5개도 포함되어 있었습니다.
흥미로운 점은 시스템 전체가 엉망이었던 것이 아니라는 점입니다.
일부 핵심 원칙은 실제 구현에서도 제대로 지켜지고 있었습니다.
반면 새로운 Architecture로 Migration하면서 과거 방식이 완전히 제거되지 않은 부분이나, 같은 Semantic Decision을 두 코드가 각각 판단하는 Duplicated Authority도 발견됐습니다.
이런 문제는 특정 API나 함수 하나만 테스트해서는 쉽게 발견하기 어려웠습니다.
Green인지보다 Red가 될 수 있는지도 확인했다
이후 테스트 방법도 조금 바뀌었습니다.
결함을 발견하면 먼저 그 문제를 재현하는 Acceptance Test를 만들었습니다.
수정 전에는 Red가 되어야 합니다.
Architecture를 수정한 뒤 Green으로 만듭니다.
그리고 여기서 끝내지 않았습니다.
일부러 잘못된 구현을 다시 넣어 테스트가 Red로 돌아가는지 확인했습니다.
예를 들어 Permission Scope 적용을 제거하거나, 두 개의 Semantic Authority를 다시 만들거나, Session의 최신 Context가 Branch Lineage를 이기도록 되돌렸습니다.
그때 해당 테스트가 실제로 실패하는지 확인했습니다.
왜냐하면 테스트가 Green이라는 사실만으로는 그 테스트가 정말 우리가 생각하는 결함을 감지하고 있는지 알 수 없기 때문입니다.
그래서 SELMA에서 중요하게 보게 된 것이 break-to-red였습니다.
이 Architecture 원칙을 깨뜨렸을 때 테스트가 정말 Red가 되는가?
AI가 코드와 테스트를 모두 만드는 시대
이 문제는 AI 코딩 시대에 더 중요해질 수도 있다고 생각합니다.
AI가 Implementation을 만들고 같은 AI가 Test까지 작성할 수 있습니다.
생산성 측면에서는 매우 강력합니다.
하지만 코드와 테스트가 같은 잘못된 가정을 공유한다면 둘은 서로를 완벽하게 검증하면서도 함께 틀릴 수 있습니다.
그래서 테스트가 필요 없다는 결론은 아닙니다.
오히려 반대입니다.
AI가 코드를 훨씬 빠르게 만드는 만큼 테스트와 검증은 더 중요해집니다.
다만 테스트의 개수와 Green 상태만으로 시스템 전체의 신뢰성을 판단해서는 부족할 수 있다는 것입니다.
제가 SELMA를 개발하면서 가장 간단하게 정리한 표현은 이것입니다.
Tests validate examples.
Invariants validate the system.
테스트는 우리가 생각한 상황에서 기능이 제대로 동작하는지 확인합니다.
Invariant는 우리가 생각하지 못한 경로에서도 시스템의 약속이 깨질 수 있는지 묻습니다.
그리고 AI가 코드를 만드는 속도가 계속 빨라진다면 앞으로 개발의 중요한 병목은 Implementation이 아니라 Confidence가 될 수도 있다고 생각합니다.
다음 9편에서는 이 Architecture Invariant를 실제 Repository에 적용한 뒤 벌어진 이야기를 다뤄보겠습니다. 처음에는 며칠이면 끝날 것으로 생각했던 리팩토링이 왜 약 일주일간의 Architecture Hardening으로 커졌는지, 그리고 AI가 만든 코드를 AI로 다시 검증해도 시간이 오래 걸렸던 이유를 실제 개발 과정 중심으로 정리하겠습니다.
#AI코딩 #바이브코딩 #ArchitectureInvariant #AI테스트 #소프트웨어테스트 #소프트웨어아키텍처 #AI코드검증 #EnterpriseAI #엔터프라이즈AI #AIEngineering #리팩토링 #SELMA