
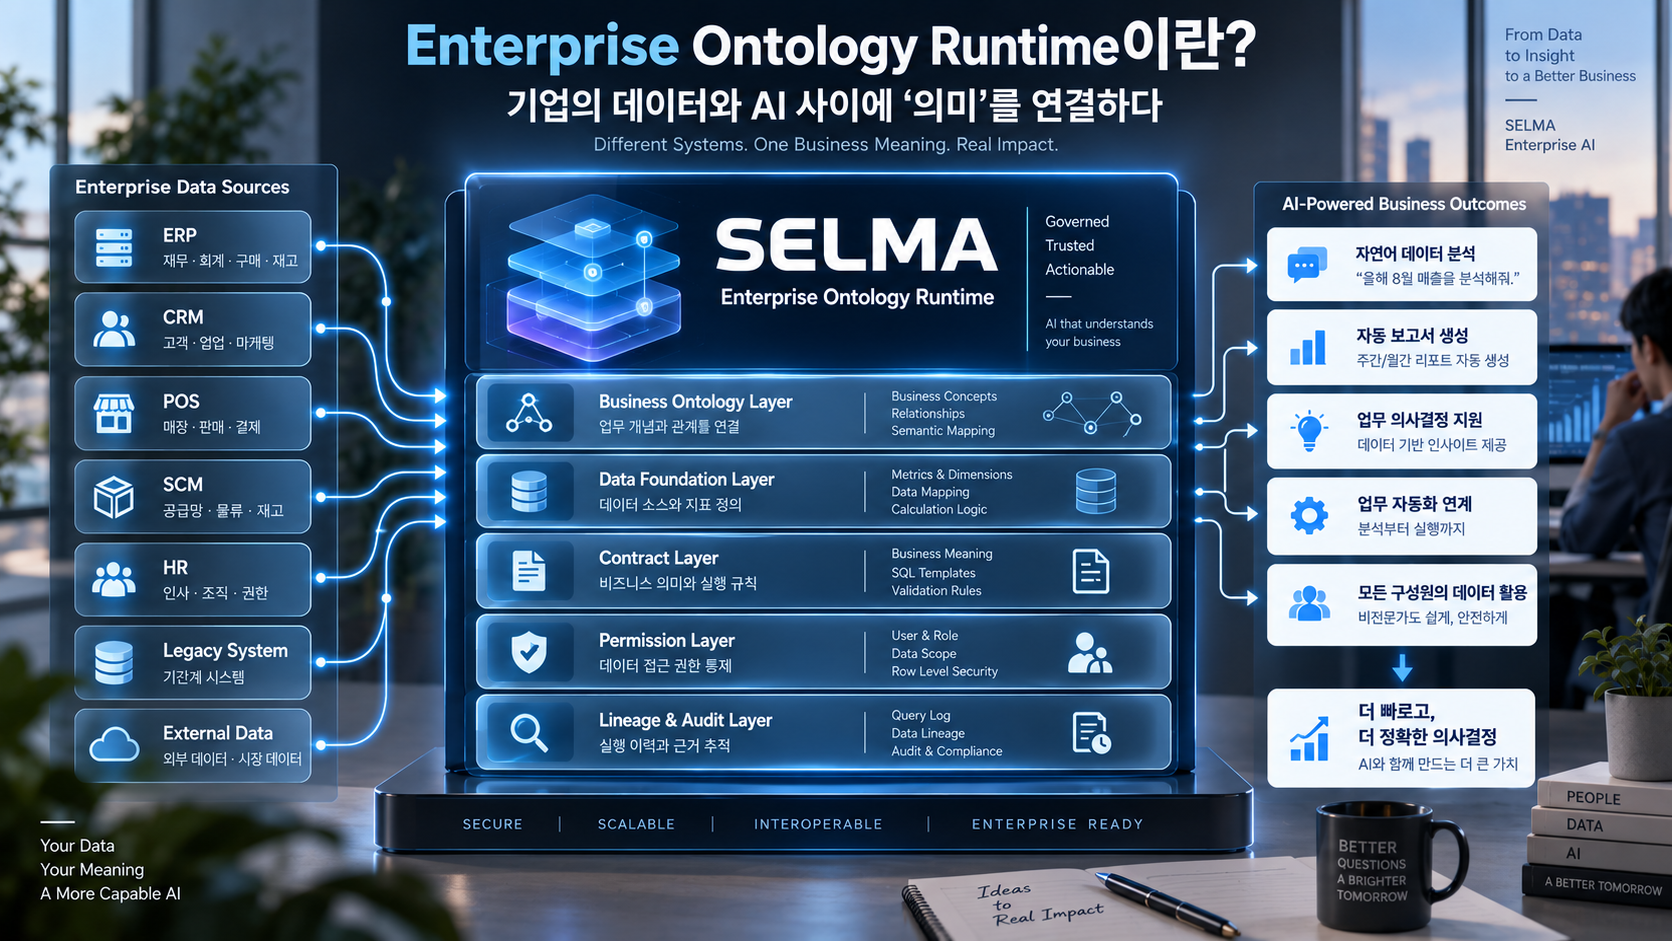
핵심 키워드: Enterprise Ontology, Enterprise AI, 온톨로지, AI 에이전트, 기업 데이터 분석, Data Foundation, SELMA
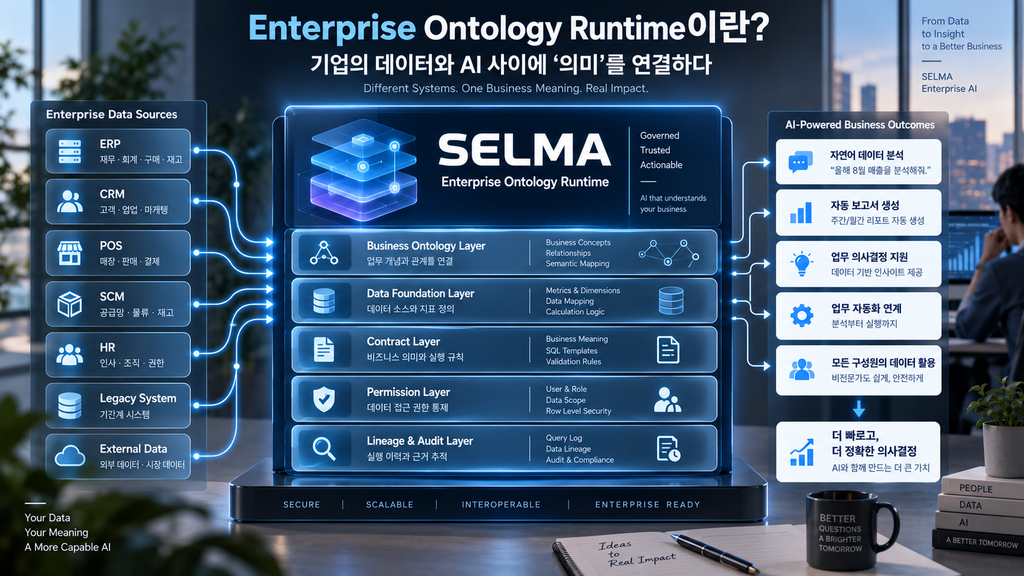
앞선 글에서는 SELMA가 LLM에게 SQL을 직접 생성하게 하지 않고 Contract를 통해 검증된 실행 경로를 만드는 이유를 이야기했습니다.
그렇다면 여기서 한 가지 질문이 생깁니다.
기업에는 ERP, CRM, POS, 고객관리, 재고관리 등 서로 다른 시스템이 존재합니다.
각 시스템은 테이블 이름도 다르고 데이터 구조도 다릅니다.
이렇게 제각각인 데이터를 AI가 어떻게 같은 업무 언어로 이해할 수 있을까요?
이 문제를 해결하기 위해 SELMA에서 중심적인 역할을 하는 개념이 Enterprise Ontology Runtime입니다.
Ontology란 무엇일까?
Ontology라는 단어는 어렵게 들리지만 기본적인 생각은 단순합니다.
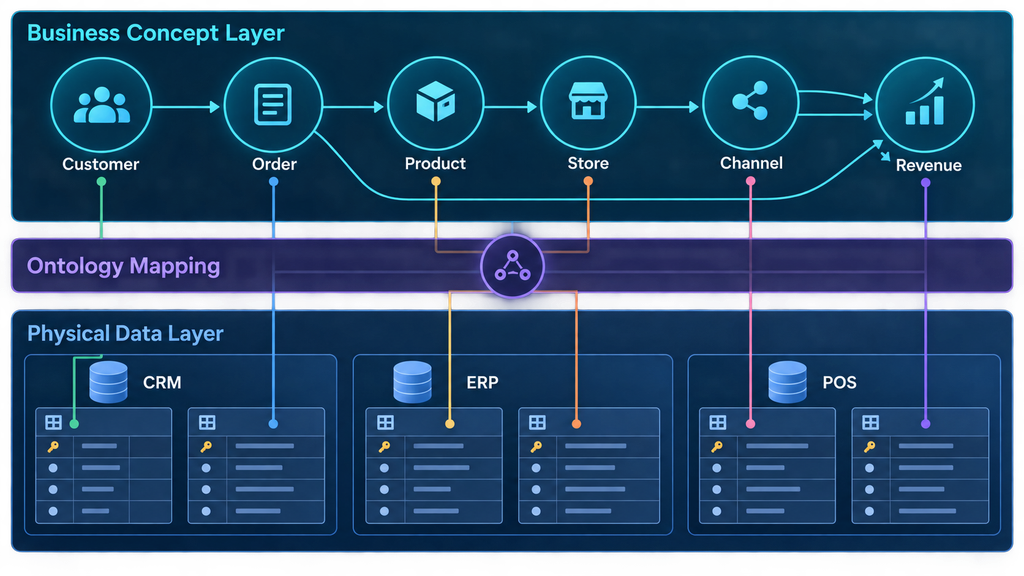
기업에서 사용하는 개념과 그 관계를 명확하게 정의하는 것입니다.
예를 들어 카페를 생각해보겠습니다.
고객이 주문하고, 주문에는 여러 품목이 포함됩니다. 품목은 특정 카테고리에 속하고 결제는 특정 매장에서 발생합니다.
이를 관계로 표현하면 다음과 같습니다.
고객 → 주문 → 품목
주문 → 결제
매장 → 주문
품목 → 카테고리
데이터베이스에서는 이것들이 여러 테이블과 컬럼으로 나뉘어 있을 수 있습니다.
하지만 사람은 테이블 이름보다 고객, 주문, 품목, 매출이라는 업무 개념으로 질문합니다.
Ontology는 이 두 세계를 연결하기 위한 의미 구조라고 볼 수 있습니다.
Data Foundation과 Ontology는 역할이 다르다
SELMA에서는 Data Foundation과 Ontology를 같은 것으로 보지 않습니다.
Data Foundation은 특정 업무 데이터를 실제로 어떻게 읽고 계산할지를 정의합니다.
예를 들어 매출이라는 Metric이 무엇인지, 품목이나 채널이라는 Dimension이 어느 데이터와 연결되는지, 어떤 기간을 사용할 수 있는지를 Contract로 선언합니다.
반면 Ontology는 개념 사이의 관계를 표현합니다.
쉽게 구분하면 다음과 같습니다.
Data Foundation = 이 숫자를 어떻게 계산할 것인가
Ontology = 이 업무 개념은 무엇과 연결되어 있는가
예를 들어 사용자가
“가장 많이 팔린 품목은?”
이라고 질문하면 Data Foundation을 이용해 판매량을 계산할 수 있습니다.
그다음
“그 품목의 재고는?”
이라고 묻는다면 품목 → 재고라는 관계를 이해해야 합니다.
이때 Ontology가 중요한 역할을 하게 됩니다.
왜 Runtime이라는 이름을 붙였을까?
SELMA에서 Ontology는 단순히 화면에 보여주기 위한 관계도가 아닙니다.
실제 질문을 해석하고 실행 경로를 선택할 때 사용되는 실행 가능한 의미 구조를 목표로 합니다.
그래서 단순히 Enterprise Ontology라고 부르기보다 Enterprise Ontology Runtime이라는 표현을 사용하고 있습니다.
사용자가 자연어로 질문하면 SELMA는 대략 다음 과정을 거칩니다.
자연어 질문 → 의미 해석 → Data Foundation 선택 → Ontology 관계 확인 → Permission 검증 → 실행 → Evidence와 함께 답변
즉 Ontology가 문서에 적힌 설계 정보로 끝나는 것이 아니라 실제 Runtime의 판단에 참여하는 구조입니다.
같은 질문도 회사마다 의미가 다를 수 있다
Enterprise AI에서 어려운 부분 중 하나는 회사마다 업무 언어가 다르다는 것입니다.
한 조직에서는 고객이라고 부르는 것을 다른 조직에서는 거래처라고 부를 수 있습니다.
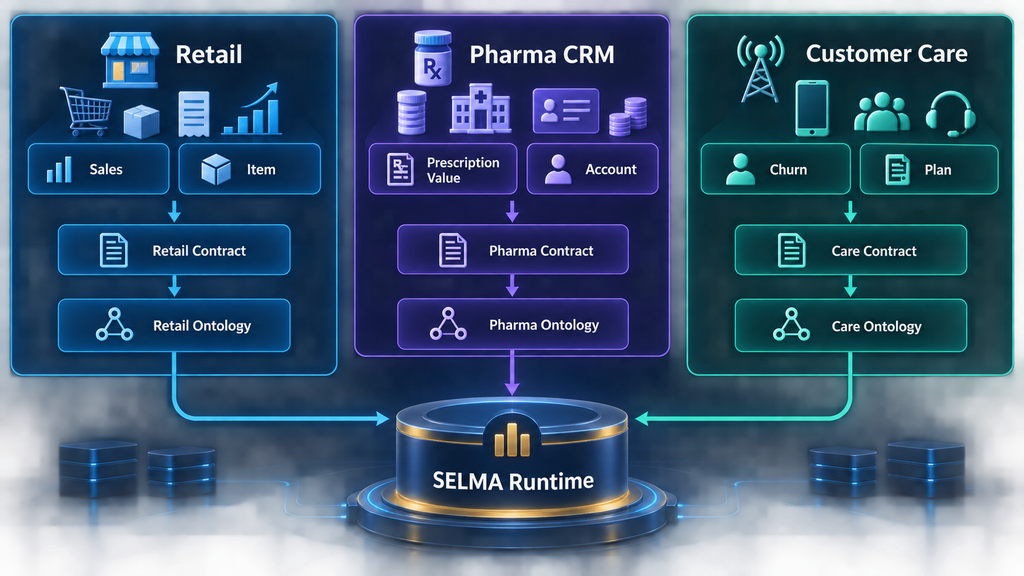
매출도 다른 산업에서는 처방액, 월 요금, 거래액처럼 전혀 다른 개념이 될 수 있습니다.
SELMA를 개발하면서 실제로 소매 데이터뿐 아니라 제약 CRM과 고객 케어처럼 서로 다른 형태의 데이터를 연결해본 이유도 여기에 있습니다.
Runtime 코드에 매출, 품목, 매장 같은 특정 산업의 단어를 계속 추가하는 방식이라면 새로운 기업이 들어올 때마다 코드를 수정해야 합니다.
제가 원하는 방향은 반대입니다.
업무 의미는 고객의 Contract와 Ontology가 선언하고, Runtime은 그것을 실행하는 문법만 갖는다.
그래야 새로운 산업을 연결할 때 Runtime 자체를 계속 다시 만들지 않을 수 있습니다.
LLM과 Ontology는 경쟁 관계가 아니다
여기서 중요한 점이 하나 있습니다.
Ontology가 있다고 해서 LLM이 필요 없어지는 것은 아닙니다.
사람은 같은 뜻을 매우 다양한 방식으로 표현합니다.
“8월 매출 알려줘.”
“지난달 장사 어땠어?”
“어떤 품목이 가장 잘 팔렸지?”
이런 자연어의 유연함을 이해하는 것은 LLM이 잘하는 영역입니다.
반면 한 번 의미가 결정된 뒤 그 의미가 기업에서 정확히 무엇을 뜻하는지는 Contract와 Ontology가 담당합니다.
그래서 SELMA의 Architecture는 LLM과 Ontology 중 하나를 선택하는 구조가 아닙니다.
LLM의 유연성과 Ontology의 구조적 의미를 결합하는 방식에 가깝습니다.
Enterprise AI에서 중요한 것은 연결된 의미다
기업에는 이미 많은 데이터가 존재합니다.
문제는 데이터가 부족해서가 아니라 서로 다른 시스템의 데이터가 업무 의미로 연결되어 있지 않은 경우가 많다는 것입니다.
AI가 기업 업무에 더 깊이 들어가려면 단순히 문서를 검색하거나 SQL을 생성하는 것을 넘어,
이 데이터가 무엇을 의미하는가?
어떤 데이터와 연결되는가?
누가 사용할 수 있는가?
어떤 계산과 실행이 허용되는가?
까지 이해할 수 있어야 한다고 생각합니다.
SELMA에서 Enterprise Ontology Runtime을 만들고 있는 이유도 여기에 있습니다.
AI에게 더 많은 데이터를 보여주는 것이 아니라, 데이터를 기업이 이해하는 의미로 연결하는 것.
이것이 SELMA Architecture의 중심 아이디어 중 하나입니다.
다음 5편에서는 조금 더 현실적인 문제를 다뤄보겠습니다.
AI가 틀린 숫자를 말하는 것보다 왜 ‘정확한 숫자로 틀린 질문에 답하는 것’이 더 위험할 수 있는지, SELMA 개발 중 실제로 발견했던 사례를 중심으로 정리해보겠습니다.
#EnterpriseOntology #Ontology #온톨로지 #EnterpriseAI #엔터프라이즈AI #AI에이전트 #DataFoundation #DataContract #기업데이터분석 #데이터거버넌스 #LLM #소프트웨어아키텍처 #SELMA