
핵심 키워드: LLM SQL, Text-to-SQL, Enterprise AI, AI 데이터 분석, Data Contract, 데이터 거버넌스, SELMA
자연어로 데이터베이스를 조회하는 Text-to-SQL은 LLM의 활용 사례 중 하나입니다.
사용자가 “지난달 매출을 알려줘”라고 질문하면 LLM이 데이터베이스 Schema를 이해하고 SQL을 생성해 결과를 보여주는 방식입니다.
직관적이고 구현 속도도 빠릅니다.
저 역시 개인 프로젝트 SELMA를 개발하면서 자연어 질문을 실제 기업 데이터와 연결해야 했습니다.
그런데 개발을 진행할수록 중요한 질문이 하나 생겼습니다.
SQL 문법이 정확하면 그 결과도 신뢰할 수 있을까?
제가 내린 결론은 그렇지 않다는 것이었습니다.
SQL이 맞아도 업무적으로 틀릴 수 있다
예를 들어 사용자가 이렇게 질문했다고 가정해보겠습니다.
“8월 매출을 알려줘.”
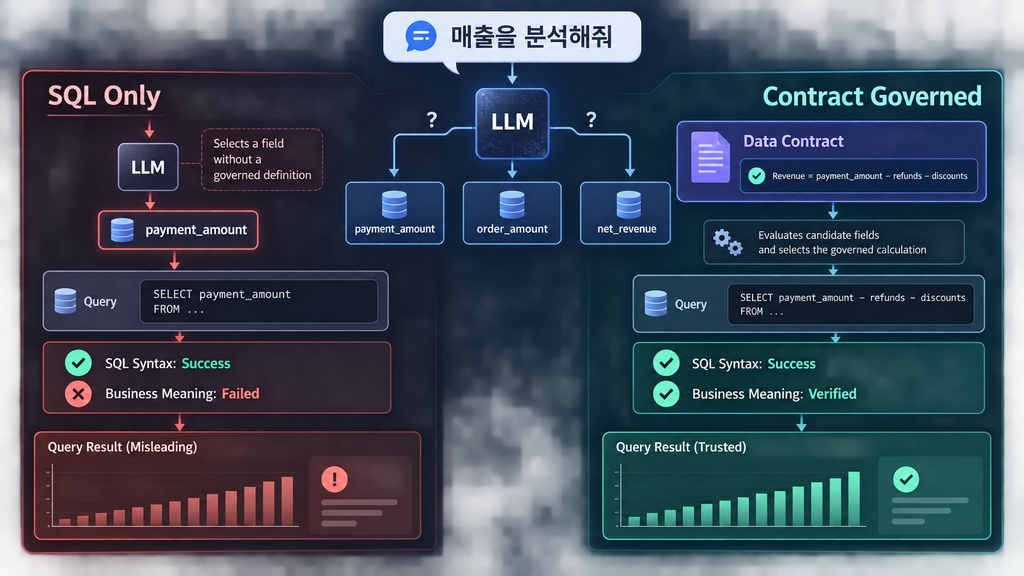
데이터베이스에는 payment_amount, order_amount, discount_amount, refund_amount처럼 여러 금액 컬럼이 존재할 수 있습니다.
LLM이 Schema와 컬럼명을 보고 payment_amount를 선택해 정상적인 SQL을 만들었다고 해보겠습니다.
SQL은 실행됩니다.
숫자도 실제 데이터입니다.
하지만 회사에서 정의하는 매출이 결제금액에서 할인과 환불을 반영한 값이라면 결과는 업무적으로 틀렸습니다.
더 위험한 것은 오류가 발생하지 않는다는 점입니다.
문법적으로 올바르고 실제 데이터에서 나온 숫자이기 때문에 사용자는 오답이라는 사실을 알아채기 어렵습니다.
SELMA는 LLM과 SQL 사이에 Contract를 둔다
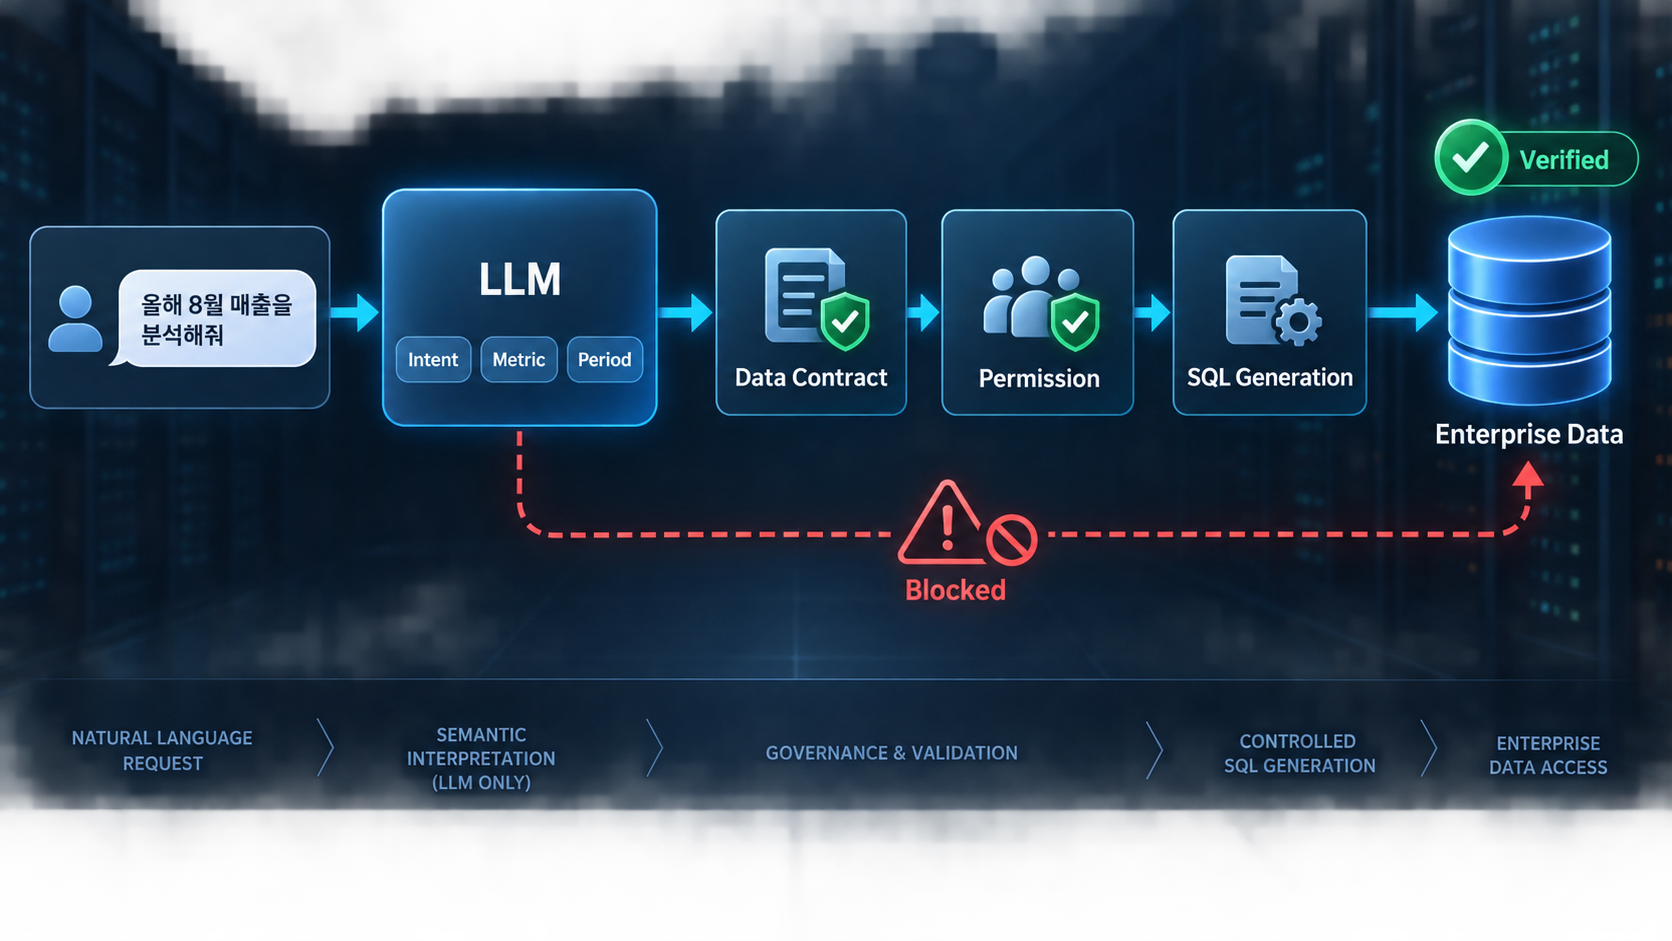
그래서 SELMA에서는 LLM의 역할과 실행 Runtime의 역할을 분리했습니다.
LLM은 자연어를 이해하는 데 사용합니다.
예를 들어,
- 무엇을 물었는가
- 어떤 기간인가
- 어떤 기준으로 나누고 싶은가
- 조회·분석·설명·비교 중 무엇을 원하는가
같은 의미를 해석합니다.
하지만 실제로 매출이 무엇을 의미하는지, 어떤 데이터 소스를 사용하고 어떤 계산을 해야 하는지는 Data Foundation Contract가 결정합니다.
구조를 단순화하면 다음과 같습니다.
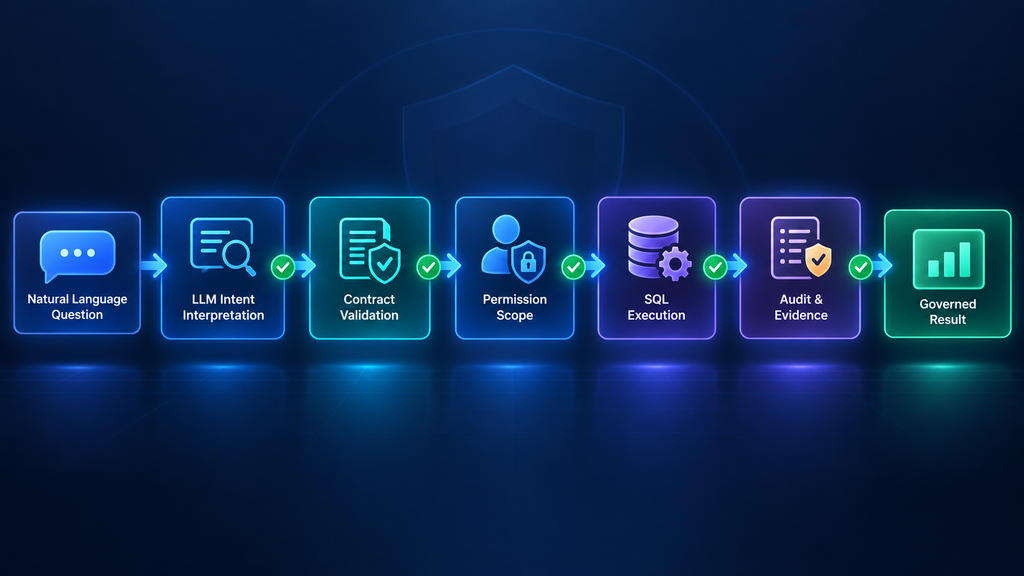
자연어 질문 → 의미 해석 → Contract Resolution → Permission Scope → 검증된 SQL → Evidence → 답변
제가 SELMA에서 중요하게 생각하는 원칙도 여기서 나왔습니다.
The LLM interprets the question.
The contract decides what can be executed.
LLM이 기업의 업무 의미까지 그때그때 추측하지 않도록 경계를 만든 것입니다.
더 좋은 LLM을 사용하면 해결되지 않을까?
당연히 모델의 성능은 중요합니다.
더 좋은 LLM은 자연어의 뉘앙스를 더 잘 이해하고 복잡한 질문도 정확하게 해석할 가능성이 높습니다.
하지만 Enterprise AI에서는 다른 문제가 있습니다.
오늘 사용한 모델과 내일 사용하는 모델이 다르다고 해서 회사의 매출 정의까지 달라져서는 안 됩니다.
또 같은 질문에 모델이 다른 SQL을 생성하더라도 기업 입장에서는 “모델이 그렇게 판단했다”는 설명만으로 충분하지 않을 수 있습니다.
SELMA에서 Business Meaning을 Contract에 두는 이유입니다.
AI 모델은 교체할 수 있지만,
기업이 정의한 지표와 계산 규칙은 독립적으로 유지되어야 한다고 생각했습니다.
Permission도 SQL 생성과 분리할 수 없다
SQL에는 계산뿐 아니라 권한 문제도 있습니다.
예를 들어 사용자가 강남점 데이터만 볼 수 있다면 LLM이 정확한 전체 매출 SQL을 만들었다고 해도 그대로 실행해서는 안 됩니다.
사용자가 어떤 데이터를 읽을 수 있는지 결정한 Permission Scope가 실제 SQL 실행까지 보존되어야 합니다.
따라서 SELMA에서 SQL 실행은 단순한 자연어 변환 문제가 아닙니다.
Business Meaning + Permission + Execution이 함께 맞아야 합니다.
LLM의 자유를 제한하는 것이 목적은 아니다
이 구조만 보면 AI의 능력을 지나치게 제한하는 것처럼 느껴질 수도 있습니다.
하지만 SELMA에서 목표로 하는 것은 LLM을 약하게 만드는 것이 아닙니다.
오히려 LLM이 잘하는 일에 더 집중시키는 것에 가깝습니다.
자연어 이해, 질문의 의도 파악, 결과 설명처럼 유연성이 필요한 부분은 AI가 담당합니다.
반면 회사의 지표 정의, 데이터 접근 범위, 실행 규칙처럼 일관성이 필요한 영역은 Contract와 Runtime이 담당합니다.
저는 이것을 Enterprise AI에서 필요한 Controlled Autonomy의 한 형태로 보고 있습니다.
AI에게 자율성을 주되, 기업이 반드시 통제해야 하는 경계는 시스템이 소유하는 방식입니다.
Text-to-SQL보다 중요한 질문
SELMA를 개발하면서 관심도 조금씩 달라졌습니다.
처음에는 이런 질문을 했습니다.
“LLM이 얼마나 정확한 SQL을 만들 수 있을까?”
지금은 오히려 이렇게 묻습니다.
“어떤 SQL이 실행되어도 기업이 정의한 의미와 권한을 벗어나지 않는다는 것을 어떻게 보장할 수 있을까?”
둘은 비슷해 보이지만 완전히 다른 문제입니다.
전자는 모델의 성능에 대한 질문이고, 후자는 시스템의 신뢰 구조에 대한 질문입니다.
기업에서 AI가 실제 데이터를 읽고 의사결정에 사용되기 시작한다면 결국 두 번째 질문이 더 중요해질 수 있다고 생각합니다.
다음 4편에서는 SELMA에서 이 구조를 한 단계 더 확장한 Enterprise Ontology Runtime이 무엇인지, 그리고 Data Foundation, Ontology, LLM이 각각 어떤 역할을 담당하도록 설계했는지 쉽게 정리해보겠습니다.
#LLM #TextToSQL #LLMSQL #EnterpriseAI #엔터프라이즈AI #AI데이터분석 #DataContract #데이터거버넌스 #AI에이전트 #ControlledAutonomy #소프트웨어아키텍처 #SELMA