
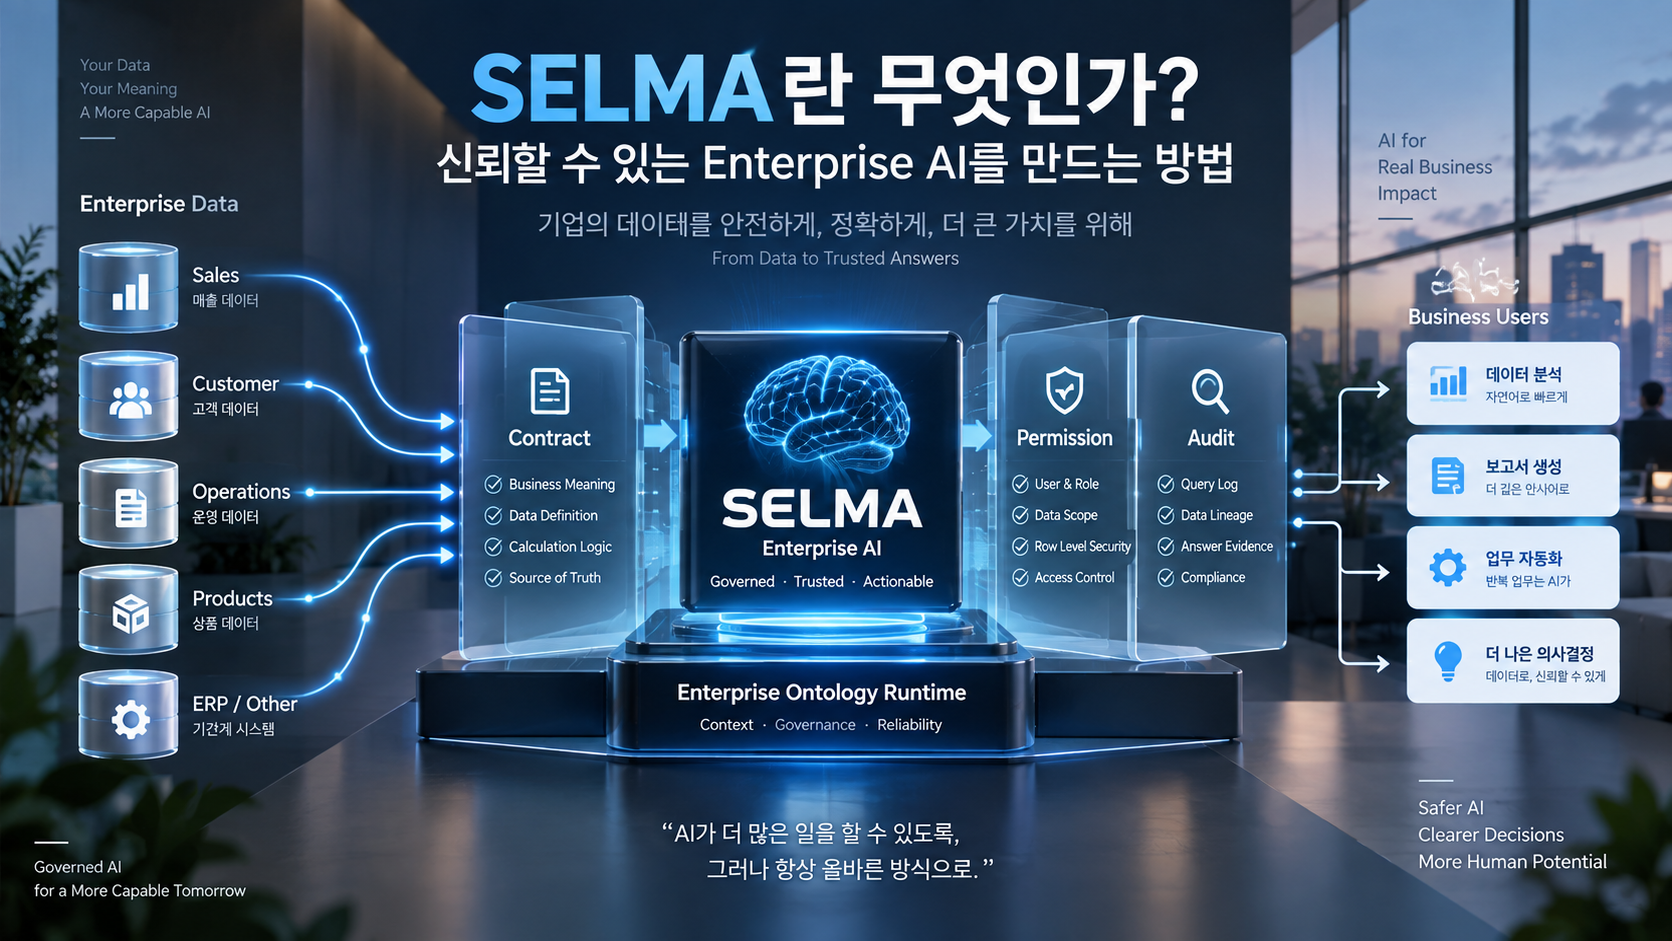
기업에서 생성형 AI와 AI Agent를 실제 업무에 활용하려는 시도가 빠르게 늘고 있습니다.
자연어로 사내 데이터를 검색하고, 매출을 분석하고, 보고서를 만들거나 업무 시스템을 직접 조작하는 것도 이제 기술적으로 불가능한 이야기가 아닙니다.
저 역시 개인 프로젝트 SELMA를 개발하면서 이런 질문에서 출발했습니다.
“기업의 데이터를 자연어로 자유롭게 분석할 수 있는 AI를 만들 수 있을까?”
처음에는 자연어를 이해하고 데이터를 조회해 답을 만드는 것이 가장 어려운 문제라고 생각했습니다.
하지만 개발을 계속할수록 더 어려운 질문이 나타났습니다.
AI가 내놓은 답을 기업은 무엇을 근거로 신뢰할 수 있을까?
이 질문이 지금의 SELMA를 만들게 된 출발점입니다.
Enterprise AI는 일반적인 챗봇과 무엇이 다를까?
일반적인 AI 챗봇에서는 답변이 조금 부정확하더라도 사용자가 다시 질문하거나 다른 정보를 확인할 수 있습니다.
기업 데이터에서는 상황이 다릅니다.
예를 들어 사용자가 이렇게 질문했다고 가정해보겠습니다.
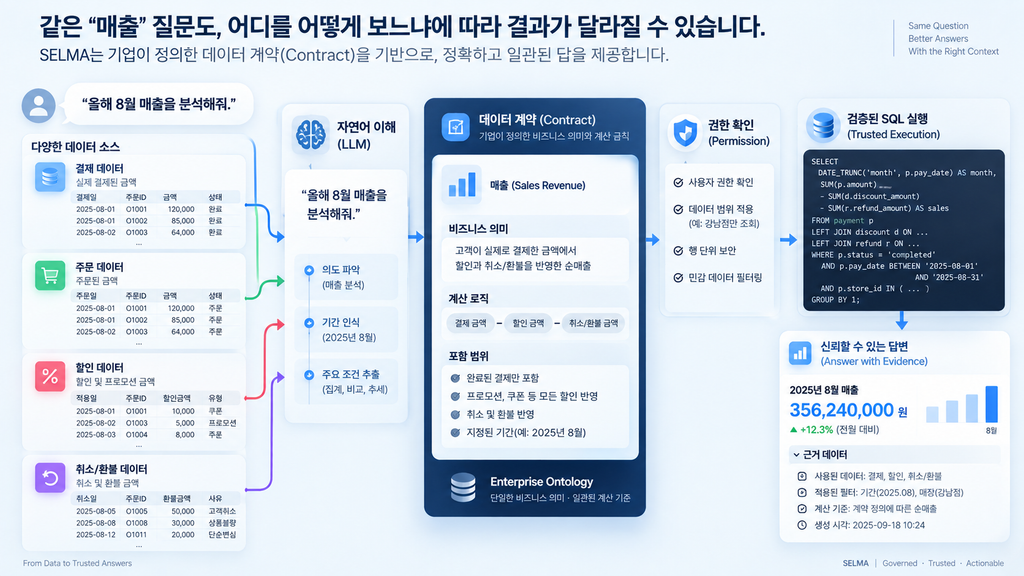
“올해 8월 매출을 분석해줘.”
AI가 3억 5천만 원이라는 숫자를 답했다고 해서 그것만으로 충분할까요?
어떤 데이터베이스를 조회했는지, 매출을 어떤 컬럼과 계산식으로 정의했는지, 취소나 할인을 포함했는지, 사용자가 해당 사업장의 데이터를 볼 권한이 있는지까지 확인해야 합니다.
숫자가 실제 데이터에서 나온 것만으로는 부족합니다.
질문의 의미, 계산 방법, 데이터 범위와 권한이 모두 맞아야 비로소 신뢰할 수 있는 답이 됩니다.
SELMA가 해결하려는 문제
SELMA는 단순히 LLM에게 데이터베이스 Schema를 보여주고 SQL을 만들어달라고 하는 방식에서 출발하지 않습니다.
현재 SELMA에서 중요한 역할을 하는 것이 Data Foundation과 Contract입니다.
기업마다 매출, 주문, 고객, 해지 같은 업무 용어의 의미가 다를 수 있기 때문입니다.
예를 들어 어떤 조직에서 매출은 결제 금액일 수 있지만 다른 조직에서는 할인과 취소를 반영한 순매출일 수 있습니다.
AI가 이름이 비슷한 컬럼을 보고 의미를 추측하도록 두면 SQL 문법은 정확해도 업무적으로는 틀린 답이 나올 수 있습니다.
그래서 SELMA에서는 역할을 나눴습니다.
LLM은 사용자의 질문을 해석합니다.
그리고 실제로 어떤 데이터를 어떻게 읽고 계산할지는 기업이 선언한 계약이 결정하도록 설계하고 있습니다.
이를 간단히 표현하면 다음과 같습니다.
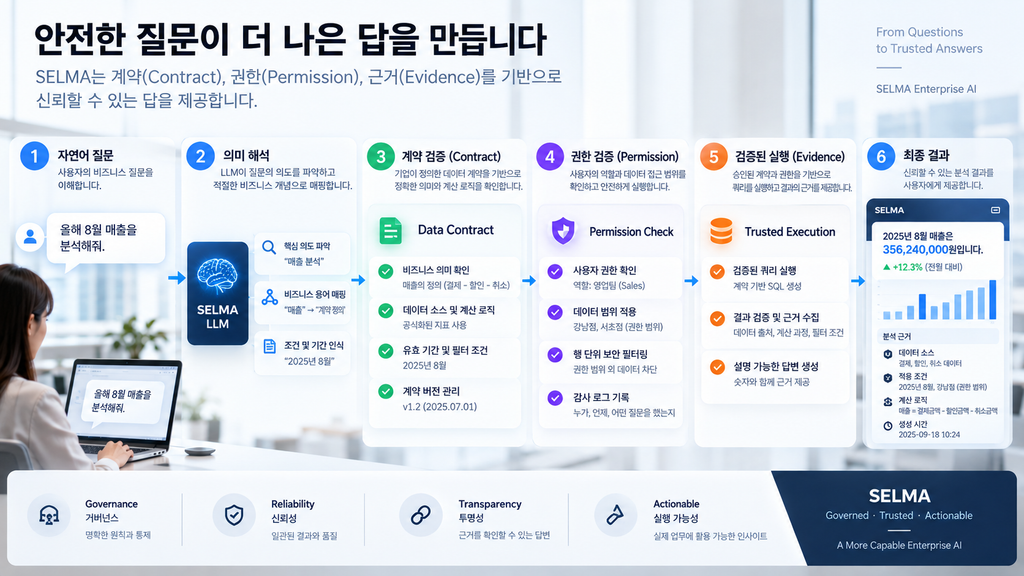
사용자 질문 → 의미 해석 → Contract 확인 → Permission Scope 확인 → 검증된 SQL 실행 → Evidence 기반 답변
즉 AI가 모든 것을 판단하는 구조가 아니라, AI의 능력과 기업이 통제해야 할 영역 사이에 경계를 두는 방식입니다.
AI가 틀리지 않는 것보다 중요한 것
SELMA를 개발하면서 가장 경계하게 된 것은 단순한 오류 메시지가 아니었습니다.
오히려 더 위험했던 것은 실제 데이터에서 나온 정확한 숫자로 다른 질문에 답하는 경우였습니다.
예를 들어 사용자가 특정 지표를 물었는데 시스템이 그것을 표현하지 못해 비슷한 지표를 대신 사용한다면 숫자 자체는 정확할 수 있습니다.
그래서 사용자는 오답이라는 사실을 알아차리기 어렵습니다.
이 경험을 통해 SELMA에는 중요한 원칙이 하나 생겼습니다.
모르는 것을 그럴듯하게 채우지 않는다.
질문의 일부를 계약이 표현할 수 없다면 조용히 다른 것으로 대체하기보다 되묻거나, 무엇이 부족한지 알려주는 편을 선택합니다.
Permission과 Audit도 처음부터 함께 생각해야 했다
기업용 AI에서는 정확한 답만큼 누가 어떤 데이터를 볼 수 있는가도 중요합니다.
사용자가 강남점 데이터만 볼 수 있다면 “전체 매장 매출을 알려줘”라고 질문하더라도 권한 밖의 데이터를 읽어서는 안 됩니다.
SELMA에서는 이런 Permission Scope가 화면이나 API에서 한 번 확인되고 끝나는 것이 아니라 실제 SQL 실행 범위까지 유지되는 구조를 지향합니다.
또한 분석 결과가 나왔다면 어떤 데이터와 계산을 근거로 만들어졌는지 추적할 수 있어야 합니다.
이 때문에 SELMA를 개발하면서 관심은 자연스럽게 AI의 답변 품질만이 아니라 Governance, Audit, Lineage, Controlled Autonomy로 넓어졌습니다.
SELMA가 지향하는 Enterprise AI
SELMA는 아직 Alpha 단계의 프로젝트입니다.
앞으로 RAG를 통한 Enterprise Knowledge 연결, Transaction Write, Approval과 같은 기능도 추가해야 합니다.
하지만 Alpha를 개발하면서 제품의 방향은 오히려 더 명확해졌습니다.
제가 만들고 싶은 것은 단순히 더 많은 질문에 대답하는 AI가 아닙니다.
자신 있게 틀린 답을 할 수 있는 경로를 줄이고,
왜 그 답을 했는지 설명할 수 있는 Enterprise AI.
AI가 자연어의 유연함을 담당하고, 기업이 통제해야 할 의미와 권한은 Contract와 Runtime이 담당하는 구조입니다.
이것이 제가 SELMA를 통해 실험하고 있는 Governed Enterprise AI의 출발점입니다.
다음 2편에서는 많은 Enterprise AI 프로젝트에서 활용하는 RAG만으로는 왜 부족하다고 생각했는지, 그리고 SELMA가 Ontology와 Contract를 함께 사용하게 된 배경을 정리해보겠습니다.
#SELMA #EnterpriseAI #엔터프라이즈AI #AI에이전트 #생성형AI #LLM #기업데이터분석 #데이터거버넌스 #AIGovernance #AI개발 #소프트웨어아키텍처 #DataGovernance #ControlledAutonomy