
핵심 키워드: SELMA, Enterprise AI, 엔터프라이즈 AI, AI Agent, Enterprise Ontology, Data Contract, AI Governance, AI 데이터 분석

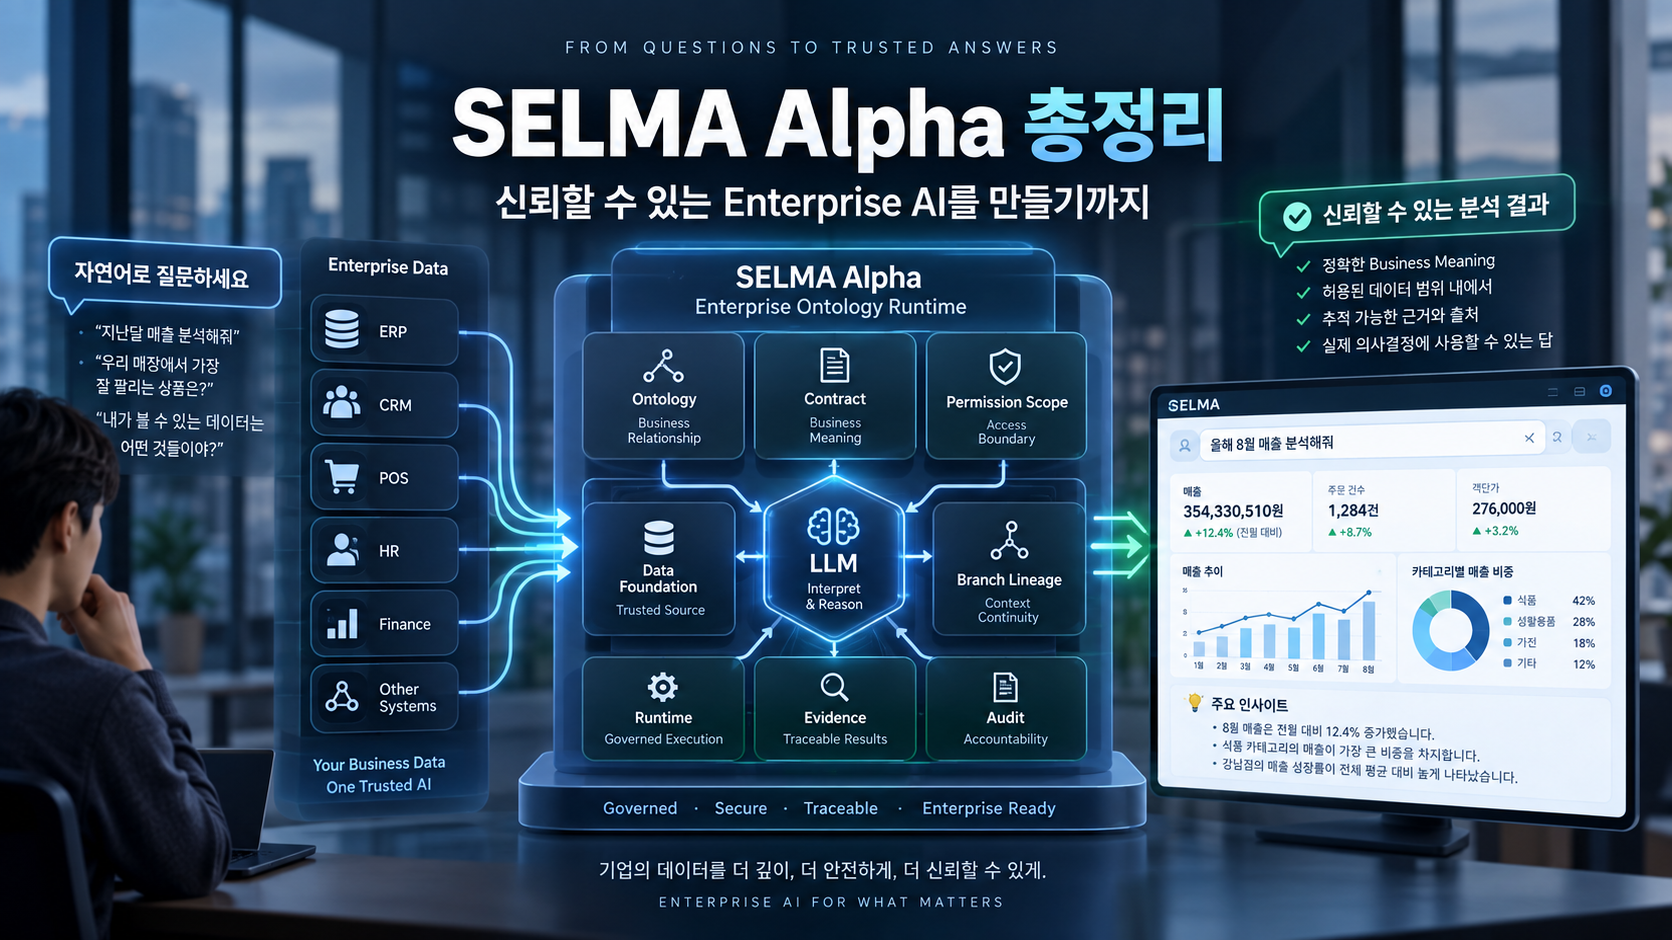
지난 12편에 걸쳐 개인 프로젝트 SELMA Alpha를 개발하면서 고민했던 내용을 정리했습니다.
처음 SELMA를 시작했을 때 목표는 비교적 단순했습니다.
기업의 데이터를 자연어로 질문하고 분석할 수 있는 AI를 만들어보자.
하지만 개발을 계속할수록 문제는 자연어를 이해하거나 SQL을 만드는 것보다 훨씬 넓어졌습니다.
AI가 말한 매출은 정말 우리 회사가 정의한 매출인가?
사용자는 그 데이터를 볼 권한이 있는가?
과거 분석을 이어갈 때 올바른 Context를 사용하고 있는가?
숫자가 맞다면 그 숫자가 정말 사용자가 물어본 질문의 답인가?
결국 SELMA Alpha에서 가장 많은 시간을 사용한 것은 AI에게 더 많은 것을 시키는 작업이 아니라 AI의 답을 신뢰할 수 있는 구조를 만드는 작업이었습니다.
1. LLM이 모든 것을 결정하지 않도록 했다
초기에는 자연어 질문을 데이터와 연결하는 것이 가장 중요한 문제처럼 보였습니다.
하지만 기업 데이터에서는 같은 매출이라는 단어도 조직마다 다른 의미를 가질 수 있습니다.
결제액일 수도 있고 할인과 환불을 반영한 순매출일 수도 있습니다.
그래서 SELMA에서는 역할을 분리했습니다.
LLM은 질문을 해석합니다.
Business Meaning은 Contract가 결정합니다.
그리고 실제 계산은 검증된 Data Foundation을 통해 실행합니다.
핵심 원칙을 한 문장으로 표현하면 다음과 같습니다.
The LLM interprets.
The governed runtime decides what can be executed.
관련 내용은 3편 ‘LLM이 SQL을 직접 생성하면 위험할까?’, 6편 ‘Business Meaning은 누가 결정해야 할까?’에서 자세히 다뤘습니다.
2. RAG와 Ontology의 역할도 분리했다
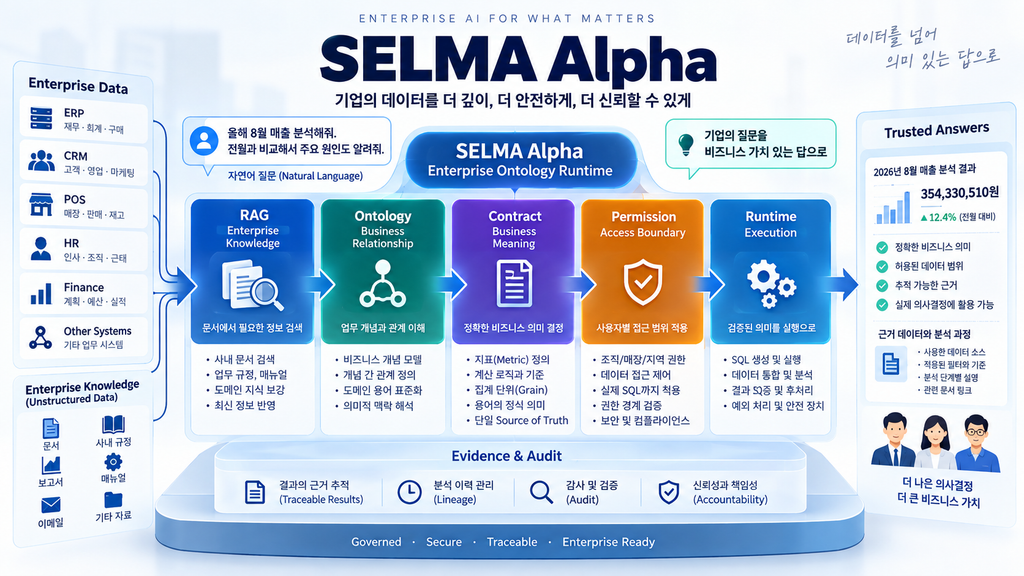
SELMA에서 RAG와 Ontology는 경쟁 기술이 아닙니다.
RAG는 문서와 Enterprise Knowledge에서 관련 정보를 찾는 데 강합니다.
반면 Ontology와 Contract는 기업에서 사용하는 개념이 무엇을 의미하고 서로 어떻게 연결되는지를 구조적으로 표현합니다.
예를 들어,
고객 → 주문 → 품목
같은 관계와 매출, 주문 건수, 해지 월요금 같은 Metric을 실제 데이터와 연결합니다.
SELMA가 단순한 RAG 챗봇이나 Text-to-SQL 도구보다 Enterprise Ontology Runtime을 지향하게 된 이유입니다.
이 내용은 2편과 4편에서 정리했습니다.
3. 권한은 실제 SQL까지 내려가야 했다
Enterprise AI에서 정확한 답만큼 중요했던 것이 Permission이었습니다.
강남점만 볼 수 있는 사용자가 “전체 매장의 매출을 알려줘”라고 질문했다고 해서 전체 데이터를 조회해서는 안 됩니다.
SELMA에서는 권한을 UI나 API 단계의 검사로 끝내지 않고 실제 SQL이 읽는 데이터 범위까지 전달하도록 구조를 정리했습니다.
이 과정에서 중요한 사실도 발견했습니다.
고객마다 권한을 표현하는 실제 데이터 구조가 달랐습니다.
어떤 데이터에서는 사업장 컬럼이 기본 테이블에 있었고, 다른 데이터에서는 여러 JOIN을 지나야 했습니다.
결국 물리적인 SQL Alias가 Permission의 의미가 되어서는 안 된다는 결론에 도달했습니다.
권한의 의미는 Contract가 선언하고, 각 Query가 자신의 구조에서 이를 Binding합니다.
7편에서 이 과정을 자세히 다뤘습니다.
4. Green Test가 올바른 Architecture를 보장하지 않았다
SELMA를 개발하면서 가장 인상적이었던 경험 중 하나입니다.
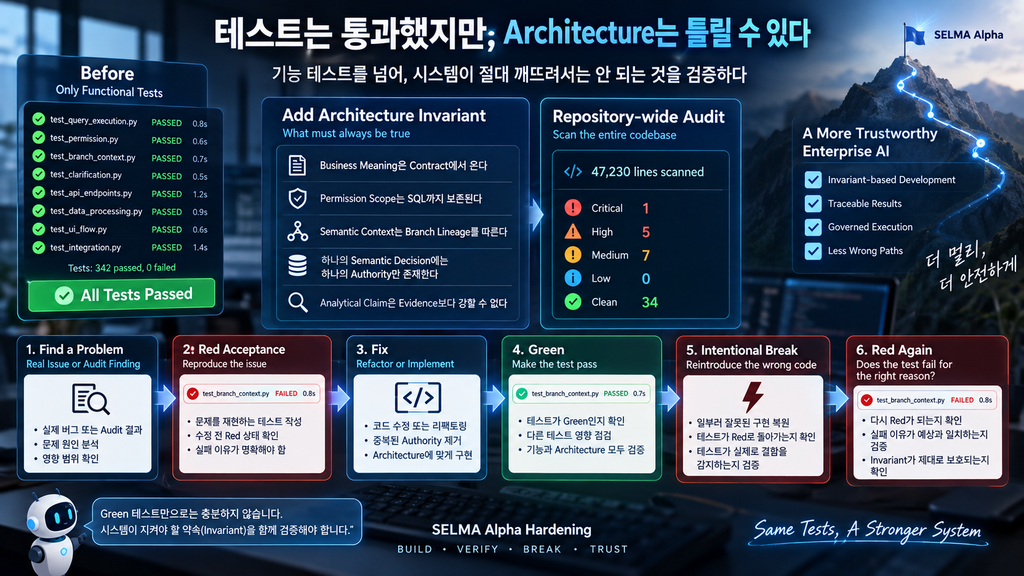
UI와 Persistence는 Branch 구조로 바뀌었는데 일부 Semantic Runtime은 여전히 Session의 가장 최근 대화를 Context로 사용하고 있었습니다.
그런데 테스트는 모두 Green이었습니다.
테스트 역시 비슷한 순서로 질문하고 있었기 때문입니다.
이 경험 이후 기능 테스트와 다른 질문을 하기 시작했습니다.
“이 기능이 동작하는가?”
가 아니라,
“어떤 실행 경로를 지나도 시스템이 절대로 깨뜨려서는 안 되는 것은 무엇인가?”
를 묻기 시작했습니다.
그리고 이를 Architecture Invariant로 만들었습니다.
Business Meaning은 Contract에서 온다.
Permission Scope는 SQL까지 보존된다.
Semantic Context는 Session Chronology가 아니라 Branch Lineage를 따른다.
하나의 Semantic Decision에는 하나의 Authority만 존재한다.
8편부터 10편까지가 바로 이 Architecture Hardening 과정에 대한 기록입니다.
5. 가장 위험한 오류는 ‘맞는 숫자로 틀린 답’을 하는 것이었다
SELMA에서 발견한 오류 중 특히 중요하게 느낀 것이 있습니다.
AI가 존재하지 않는 숫자를 만들어낸 것이 아니었습니다.
실제 데이터에서 가져온 정확한 숫자를 사용해 다른 질문에 답하는 경우였습니다.
Metric이 다르거나 Dimension 일부가 사라졌는데도 실행을 계속하면 SQL은 성공할 수 있습니다.
사용자는 실제 숫자를 보게 됩니다.
그래서 오히려 잘못된 답이라는 사실을 발견하기 어렵습니다.
이후 SELMA에서는 Contract가 표현할 수 없는 질문을 비슷한 의미로 조용히 바꾸기보다 되묻거나 부족한 의미를 드러내는 방향으로 바뀌었습니다.
5편에서 이 문제를 집중적으로 다뤘습니다.
6. 마지막에는 사람이 새로운 문제를 발견했다
Architecture Hardening을 완료한 뒤 실제 사이트를 열었습니다.
그리고 이렇게 질문했습니다.
“올해 8월 매출 분석해줘.”
SELMA는 정확한 매출 숫자를 알려줬습니다.
하지만 분석은 하지 않았습니다.
알려줘와 분석해줘가 사실상 같은 실행 계획으로 처리되고 있었던 것입니다.
이를 수정한 뒤 다시 물었습니다.
“내가 볼 수 있는 데이터는 어떤 것들이 있지?”
이번에는 원하는 목록은 나왔지만 질문 자체를 제대로 이해하지 못했습니다.
SELMA에 Capability Discovery라는 질문 종류 자체가 없었기 때문입니다.
복잡한 Architecture Test가 아니라 평범한 사람의 질문 두 개가 새로운 종류의 결함을 찾아냈습니다.
그래서 SELMA Alpha에서는 Human Acceptance가 중요한 다음 관문이 됐습니다.
11편에서 이 과정을 자세히 기록했습니다.
SELMA Alpha가 도달한 곳
지난 12편의 내용을 압축하면 SELMA Alpha에서 만들려고 한 것은 단순한 AI 데이터 분석 기능이 아니었습니다.
Natural Language는 LLM이 이해합니다.
Business Meaning은 Contract가 소유합니다.
Business Relationship은 Ontology가 표현합니다.
Permission은 실제 실행 범위까지 유지됩니다.
Context는 Branch Lineage가 보존합니다.
Execution은 Governed Runtime이 담당합니다.
Evidence와 Audit은 답이 어디에서 나왔는지 추적할 수 있게 합니다.
이 구조가 제가 현재 Governed Enterprise AI라고 부르는 SELMA의 기반입니다.
Alpha 이후에는 무엇을 만들까?
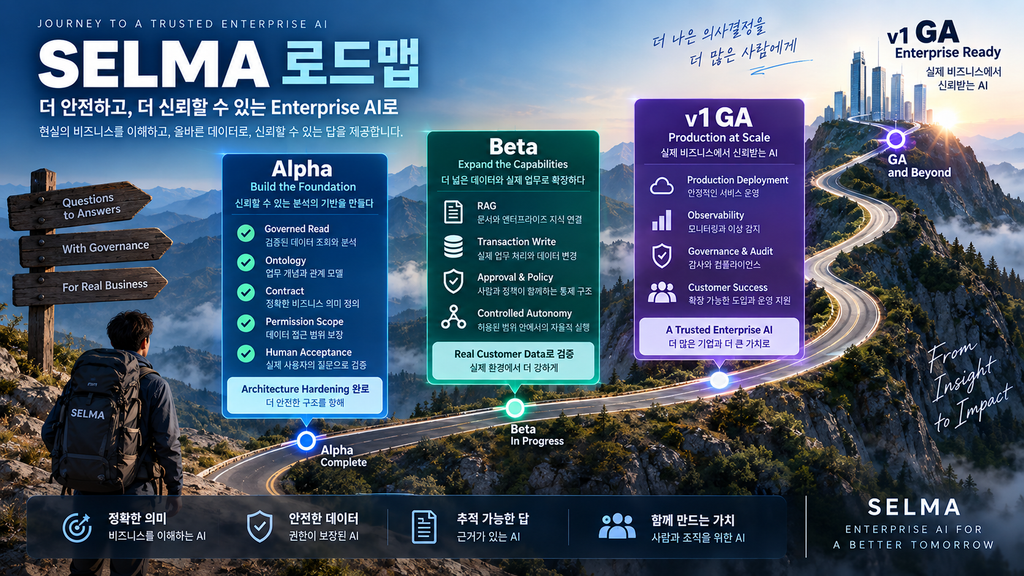
SELMA는 아직 완성된 제품이 아닙니다.
Alpha에서는 주로 Governed Read와 Analytics의 기반을 만드는 데 집중했습니다.
다음 단계에서는 Enterprise Knowledge를 연결하는 RAG, 그리고 AI가 데이터를 읽는 것을 넘어 실제 업무 상태를 변경하는 Transaction Write가 중요한 주제가 될 예정입니다.
특히 Write가 시작되면 Permission만으로 충분하지 않습니다.
Approval, Policy, Transaction Boundary, Audit, Human-in-the-loop 같은 통제 구조가 더욱 중요해집니다.
12편을 마치며
SELMA Alpha를 개발하면서 처음에는 AI가 얼마나 많은 일을 할 수 있는지에 관심이 많았습니다.
지금은 질문이 조금 달라졌습니다.
AI에게 얼마나 많은 일을 시킬 수 있는가보다, 무엇을 근거로 그 결과를 신뢰할 수 있는가.
그리고 지난 Alpha 개발을 가장 잘 설명하는 문장은 이것이라고 생각합니다.
The goal is not to make AI answer more questions.
The goal is to eliminate the paths by which it can confidently answer the wrong one.
더 많은 질문에 답하게 만드는 것보다 자신 있게 틀릴 수 있는 경로를 하나씩 제거하는 것.
이것이 SELMA Alpha에서 가장 중요하게 배운 내용입니다.
앞으로는 Alpha에서 만든 이 원칙들이 RAG와 Transaction Write, 그리고 실제 고객 데이터에서도 유지될 수 있는지를 계속 검증해보려고 합니다.
#SELMA #EnterpriseAI #엔터프라이즈AI #AI에이전트 #EnterpriseOntology #DataContract #AIGovernance #AI데이터분석 #DataGovernance #ArchitectureInvariant #ControlledAutonomy #RAG #LLM #AI개발